
В команде Claude Code почти весь код (~90%) пишет и ревьюит Claude — и они опубликовали большой разбор того, как при таком раскладе проверять качество. Автор — Адди Османи (Addy Osmani), инженер Anthropic, до этого много лет руководил Chrome-командой в Google. Читать стоит всем, кто делегирует агентам реальный код и устал проверять всё руками.
Главная мысль: агенту нужно дать способ проверить свою работу доказательствами — тогда один человек сможет держать десятки параллельных сессий, а не одну-две.
Суть подхода
Циклы проверки — базовый элемент делегирования. Без них реально запускать одного-двух Claude одновременно, потому что всё приходится проверять самому. С ними — десятки и сотни параллельно.
Проверка напрямую поднимает качество. Во внутренних тестах на структурированную генерацию файлов отдельный агент-оценщик, сверявший работу Claude с чек-листом критериев, поднимал долю успешно выполненных задач до 10 пунктов по сравнению с обычным промптом. Самый большой выигрыш был на самых сложных задачах.
То, что раньше было дорого проверить, теперь дёшево попросить у агента. Тесты, бенчмарки, спецификации и настоящие сквозные прогоны агенты генерируют так же быстро, как код. А раз сгенерированы — они запускаются как обычный софт: часто и почти без лишних токенов.
Цикл можно замкнуть и по-другому: превратить провал в правило. Если агент раз за разом проваливает тест, который ищет пользовательские данные в логах, — сделайте hook или явное правило в CLAUDE.md, и проблема (почти) не повторится.
Отсюда два вопроса статьи: какие тесты выбирать и как расставить их по конвейеру.
Не все тесты одинаково полезны: три вида, в которые стоит вкладываться
Какой бы тип вы ни выбрали, есть типовые проблемы:
- Нестабильные тесты (flaky) учат агента перезапускать их, а не чинить код. Агент просто гоняет тест по кругу до зелёного.
- Медленные тесты заставляют агент прогонять их меньше за партию. Искать источник проблемы становится труднее.
- Тяжёлые проверки лучше ставить до коммита изменений, а не после.
Сквозные тесты (E2E)
Если выбирать один тип — берите end-to-end. Такие тесты описывают реальные сценарии пользователя: добавить товар в корзину, оформить заказ, попасть на страницу подтверждения.
E2E-тесты эффективны, потому что их трудно обмануть: либо фича работает целиком, либо нет. У них чёткий критерий «готово» и они конкретно говорят, что сломалось.
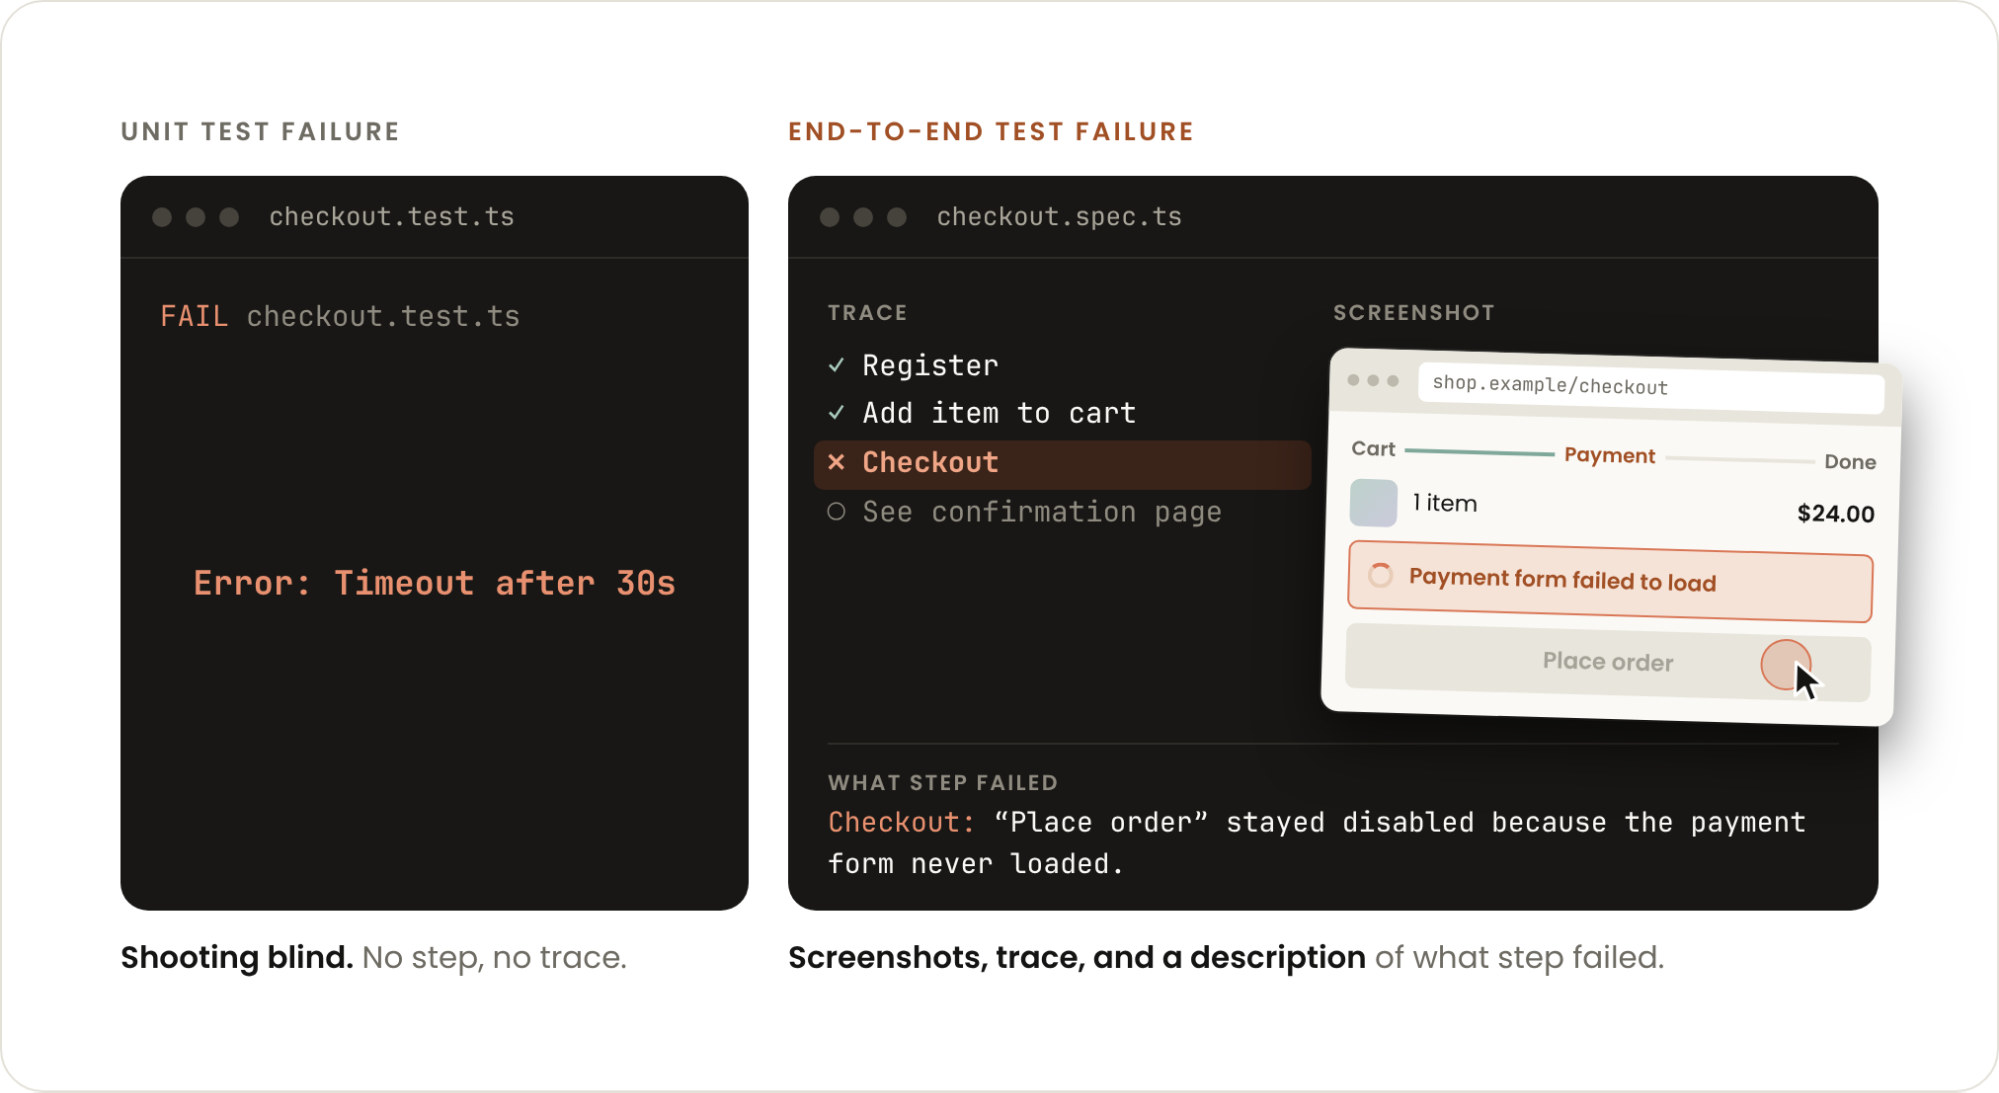
Юнит-тест может показать «Error: Timeout after 30 seconds», а сквозной тест покажет скриншот и описание того, какой именно шаг сломался.
Юнит-тесты быстрее и стабильнее, но можно их пройти и всё равно сломать фичу: ни агент, ни тест не понимают задачу целиком.
С E2E хорошо работает приём: дать агенту «руки и глаза» на реально запущенном приложении. Через skill можно запускать, управлять и инспектировать приложение инструментами вроде CDP (протокол управления браузером Chrome), симуляторов или API-обвязок.
Карта фич обычно перечисляет функции глазами пользователя — с описанием путей, горячих клавиш, селекторов и ожидаемого результата. Она служит агентам одновременно справочником и рубрикой для оценки.
Property-тесты: ограничения, которые нельзя нарушить
Обычные тесты построены на догадках, что может пойти не так. Property-тесты (тесты свойств) нацелены на крайние случаи, которые люди обычно пропускают, — и именно на них чаще всего ломаются агенты.
Вы пишете утверждение, которое, как кажется, нарушить невозможно, а тестовая библиотека (fast-check для JS/TS, Hypothesis для Python, proptest для Rust и т. п.) генерирует тысячи входных данных, пытаясь доказать обратное.
Свойства есть почти в любом проекте:
- Обратимое кодирование: «закодировал X, декодировал — получил X». Работает и для парсинга, и для сериализации.
- Инварианты: то, что всегда должно быть правдой, например «баланс аккаунта не может стать отрицательным».
- Идемпотентность: действие (миграция, нормализация, повторный запуск), выполненное дважды, даёт тот же эффект, что и один раз.
- Эквивалентность: оптимизированный код даёт тот же результат, что наивный, но правильный.
Property-библиотеки хорошо держат агентов в честности: крайние случаи генерируются без тех же предубеждений, что у агента, написавшего исходный код. Они особенно полезны при переписываниях, когда спецификация уже отошла от реального поведения в проде и больше не годится как источник истины.
Differential-тесты: старая система как эталон
Differential-тесты (сравнительные) особенно эффективны для больших миграций, где поведение должно остаться прежним. Вы прогоняете старую и новую систему на одинаковых входных данных и смотрите, расходятся ли результаты. Расходятся — есть баг или ломающее изменение.
Ключ к ним — случайные входные данные или выборка реального продового трафика. Ещё стоит нормализовать неважные различия вроде пробелов и вести список одобренных изменений — для случаев, где новая среда должна отличаться от старой.
Как команда Claude Code проверяет свою работу
Команда уже писала про код-ревью в Anthropic, здесь же — глубже про проверку.
Проверка — это запустить изменение
Прогнать приложение целиком важнее, чем тесты. Вы бы не выпустили изменение в iOS-приложении, не покрутив его в симуляторе, — с Claude то же самое.
Claude может протестировать всё приложение так, как это сделал бы человек или QA-инженер: для веба — расширение Claude для Chrome, для мобильного — iOS или Android MCP, для десктопа — computer use, для бэкенда — запустить сервис локально.
Чтобы формализовать запуск, создайте skill с именем verify. Положите его в папку .claude/skills/ в репозитории, как можно ближе к нужному коду, и добавляйте столько, сколько нужно. Claude знает, что перед коммитом надо использовать verify.
Дальше вкладывайтесь в то, чтобы этот skill был быстрым и надёжным: просите Claude его улучшать и гонять по жёстким сценариям. Это ваш смоук-тест (быстрая проверка «приложение вообще живёт»), он должен быть железобетонным.
Когда у Claude есть способ быстро проверить свои правки целиком, результат заметно лучше. Агент итерирует и ловит реальные ошибки быстрее, как сделал бы человек. Так команда тестирует почти все изменения в Anthropic.
Проваленные тесты требуют человека
Никто не прочитает каждое изменение, поэтому провалы — один из сигналов, что нужен человек. Claude гоняет проверки и пытается починить всё, что падает. Если проверка падает после трёх раундов, Claude останавливается и зовёт человека.
Владельцы кода пишут свои проверки
Владельцы кода сами пишут проверки для него и доводят их до состояния, когда они помечают ровно то, что пометил бы владелец. Когда проверка дёргает ревьюера, она должна объяснять почему — чтобы ему не приходилось разгадывать это по диффу.
Проверки надёжности срабатывают по диффу
Команда ведёт чек-лист надёжности из 39 пунктов. У каждого есть триггер, читаемый из диффа, сама проверка, а также инциденты или PR, из которых он вырос. Один из пунктов: «--resume загружает старые transcripts» (то есть восстановление прошлой сессии по сохранённой истории переписки). Когда меняется хранилище сессий или типы сообщений, команда спрашивает: безопасно ли загрузится новое поле, ведь в старых историях его нет.
Claude читает дифф и проверяет только пункты, чей триггер совпал, — обычно 3–10. Никому не нужно помнить прошлые аварии наизусть.
Один ревьюер, несколько раундов
Команда не улучшает ревью, навешивая больше ревьюеров. Дорогой второй ревьюер поверх основного часто работает хуже, чем настройка основного. Вместо этого есть REVIEW.md — файл, где написано, на что ревьюеру смотреть в этом коде.
Раунды ревью и проверки должны опираться друг на друга. Каждый следующий проход получает контекст прошлых раундов и прошлых провалов, а не перепроверяет всё с нуля. Так дешевле и находится больше.
Изменение не может править собственные проверки
Если изменение может поменять проверку, которая его судит, — проверка сломана. Code Review читает REVIEW.md из базовой или дефолтной ветки и никогда — из изменений pull request. Команда следит, чтобы правила, через которые проходят изменения, лежали в ветке, которую само изменение править не может.
Ревью привязано к коммиту. Если кто-то пушит, пока идёт ревью, результат уже бесполезен: пройденное ревью на устаревшем коммите ничего не значит.
Дешёвые проверки идут первыми. Если агент пушит, не прогнав тесты локально, он тратит общее время ревью и CI, хотя мог поймать баг сам. У команды Claude перед открытием PR гоняет тесты, сборку и линтер. Принудительно это можно устроить hook’ом, который запускает тесты, когда Claude закончил работу, или командой /goal с целью «тесты зелёные».
Новый заслон сначала в режиме наблюдения
В репозиториях команды на каждый коммит ставится метка о том, как он проверялся. В метке даже есть вариант «none» — чтобы можно было найти коммиты без проверки вообще.
Ещё сделан gate (заслон на коммит), который может блокировать коммит, если в сессии не было /code-review или /verify. У него три режима: off, observe и enforce.
observeтолько логирует то, что было бы заблокировано — так команда разбирает ложные срабатывания и убеждается, что никому не мешает.enforceблокирует коммит. В сообщении коммита можно объяснить, почему он прошёл без проверки. Если за сессию уже дважды заблокировали коммиты, следующий пропустят — чтобы Claude не застрял: Claude Code не идеален.
Проверяйте сами проверки на том, что важно
Команда регулярно ревьюит ревьюеров. Считается, сколько слитых изменений откатили, сколько мейнтейнер отверг до слияния, и смотрится подобранный по размеру набор изменений, которые так и остались чистыми.
То же можно оформить как формальную оценку. Команда Code Review в Anthropic построила её на прошлых инцидентах и откатах: для каждого примера репозиторий восстанавливается в состояние на момент ревью, а ответом служит одно предложение — в чём был баг. Очки получают только находки, которые правильно описывают этот баг. Слитые и стабильные изменения служат контрольной группой, чтобы система не начала флажить всё подряд. Набор для настройки отделён от фиксированного тестового набора, которым оценивают систему.
Полноту покрытия меряют отдельно для сырых находок, после верификации и в финальном ревью. Так видно, не теряет ли система баги, которые уже нашла. Любая оценка, где это один сквозной балл, такой нюанс не поймает.
Кроме валидности, важна значимость: хороший ревьюер поймает почти всё формально корректное, но людям важно, баг это must-fix, should-fix или мелочь.
Code Review устроен ровно так: находки помечаются как Important, Nit или Pre-existing. Метка Pre-existing означает, что ревьюер не вменяет автору баг, который был до его изменений.
Наконец, полноту настраивают до точки, где дальнейшее улучшение — уже подгонка под тестовый набор, а не новые пойманные баги.
Превращайте пропуски в правила
В репозитории Claude Code два способа превратить пропущенные случаи в правила.
Первый — извлекать паттерны из комментариев людей в код-ревью и откатов PR. Кандидат должен встретиться минимум в двух PR и быть узнаваем по диффу. Три агента пытаются опровергнуть кандидата, а потом его ревьюят и одобряют люди в PR.
Второй — прогнать трёх искателей багов по PR, связанному с известным инцидентом. Если баг нашли минимум два из трёх — он детектируемый. Если баг пропущен на маленьком диффе, это пробел, который стоит превратить в правило в REVIEW.md.
Нестабильные тесты обрабатывают так же жёстко. Claude не может их пропускать, вставлять паузы или перезапускать до зелёного. Если не нашёл первопричину — удаляет тест и записывает, почему.
Правила тоже надо чистить. Наборы тестов, шаги проверки и .md-файлы растут сами собой, поэтому их регулярно прореживают.
Хорошие тесты — хороший результат
Команда сформулировала итог так: относитесь к слою проверки как к любой другой системе. Держите его вне досягаемости тех изменений, которые он судит; оценивайте по багам, которые были для вас важны; записывайте уроки, когда он что-то пропустил, чтобы это не повторилось, и прореживайте эти уроки, чтобы они оставались стоящими.
Тогда ваша работа сместится с чтения каждого диффа на определение того, как выглядит «готово», и проверку доказательств — а это именно то, что позволяет запускать много Claude одновременно.
Фактчек
- ~90% кода пишет и ревьюит Claude — внутренняя самооценка Anthropic, проверить нечем. Похожие цифры команда уже звучала в их ранних постах про код-ревью, но это отчёт самой компании, а не независимая проверка.
- «+10 пунктов успеха» от отдельного оценщика — данные внутренних тестов, методика не раскрыта. Проверить невозможно, относитесь как к маркетинговой цифре.
- Инструменты реальные: skills (папка
.claude/skills/), hooks, код-ревью с кастомизацией черезREVIEW.md, расширение Claude для Chrome, computer use — всё это существующие механизмы Claude Code и Anthropic, и ссылки в статье ведут на официальную документациюcode.claude.com. - Метки
Important,Nit,Pre-existingи чтениеREVIEW.mdиз базовой ветки — поведение подтверждается только ссылками на официальные доки внутри самой статьи; независимо я это проверить не могу. - Команды
/goalи/verify— на них ведут официальные ссылки из статьи, но в известных мне версиях Claude Code таких команд раньше не было. Похоже на свежие нововведения; как они работают, проверить нечем. - iOS и Android MCP — официальных мобильных MCP-серверов от Anthropic в известных мне материалах нет, в статье упоминание без ссылки. Возможно, речь о сторонних серверах для симуляторов — уточнять нечего.
- 39 пунктов чек-листа, три раунда до эскалации, три агента-опровергателя, два из трёх искателей багов — внутренние процессы команды. Проверить нечем, доверять можно только на слово.
- Библиотеки
fast-check,Hypothesis,proptest— реальные и популярные инструменты для property-тестов в JS/TS, Python и Rust. Здесь всё сходится. - Автор — Адди Османи действительно многолетний известный инженер из Google (команда Chrome), и его переход в Anthropic на позицию Member of Technical Staff публично известен. Дата публикации — 2026-11-16, фиксируем как заявленную.
Как применить
- Заведите skill
verifyв.claude/skills/с шагами: как поднять приложение, что открыть, что проверить. Потом попросите Claude его улучшить и прогнать по жёстким сценариям — это ваш смоук-тест. - Начните с E2E-тестов на 3–5 ключевых сценариев пользователя. По статье это самый выгодный тип: их трудно обмануть, и они точно показывают, что сломалось.
- Добавьте property-тесты там, где есть данные: парсинг, сериализация, деньги, очереди. Библиотеки —
fast-check(JS/TS),Hypothesis(Python),proptest(Rust). Начните с round-trip («закодировал — декодировал»), инвариантов и идемпотентности. - Миграции проверяйте дифференциально: гоняйте старую и новую версию на одних входных, нормализуйте пробелы, ведите список одобренных различий.
- Напишите
REVIEW.mdс тем, на что смотреть ревью в вашем коде. И следите, чтобы изменения не могли его править — файл должен жить в защищённой ветке. - Настройте hook, который гоняет тесты и линтер, когда Claude закончил работу, или задайте цель через
/goal— зелёные тесты перед пушем. - Любой новый заслон (
/code-review,/verify) включайте сначала в режимеobserve: смотрите лог блокировок, отсеивайте ложные срабатывания, и только потом переходите наenforce. - Раз в спринт чистите: нестабильные тесты — чинить или удалять с записью причины, правила в
REVIEW.md— прореживать, иначе они разрастутся и перестанут работать. - Кому это нужно: командам, которые уже гоняют Claude Code на живом проекте и хотят делегировать агенту больше одной задачи за раз.