
Anthropic 16 сентября 2026 года запустила Claude Docs — совместный редактор документов, куда Claude может заходить прямо из чата или Claude Code. Инженер Vivek Nair написал на claude.dev, как они готовили сервис под ним к ударному запуску: за две недели до релиза он оставил сессию Claude Code работать без остановки на тестовой копии сервиса — та генерировала нагрузку, ломала компоненты и сама всё чинила.
Цифры на выходе выглядят неправдоподобно: 4,6 миллиона документов и 2 миллиарда запросов за первую неделю — и всего 60 серверных ошибок, ни одного отката. Ниже — полный перевод, а после него мой разбор: что тут похоже на правду, что на маркетинг, и как повторить такой цикл на своём сервисе.
Claude Docs — это редактор документов, в котором вместе работают ты, твои коллеги и Claude. Самое интересное: сессия Claude откуда угодно — из чата или из Claude Code — может открыть тот же документ и читать, писать и комментировать в нём вживую, рядом с тобой. Docs вышли 16 сентября 2026 года. Этот пост — про сервис, на котором всё это крутится.
За три недели до открытия Claude Docs для всех это был прототип на одной машине, которым пользовались несколько тысяч человек внутри Anthropic. Мы шли к амбициозной дате релиза, и наша собственная оценка обещала миллионы документов в первые же дни.
Мы запустились 16 сентября. К 22 сентября люди создали больше 4,6 миллиона документов. На 2 миллиардах запросов мы увидели всего 60 серверных ошибок, и ни разу не пришлось откатываться. Весь сервис Docs работал примерно на 50 подах (контейнерах) с увеличенным объёмом памяти.
К этому привели два решения:
- Хаос-цикл в масштабе запуска. Мы собрали тестовый стенд на staging (тестовая копия продакшена), где Claude две недели безостановочно пытался сломать сервис. Он нагружал каждую часть инфраструктуры и чинил всё, что падало.
- Сервис, понятный Claude. Claude мог замыкать цикл правок только если система на каждой итерации выдавала точную телеметрию (метрики своей работы). Мы заранее решили не брать среды исполнения, которые расходуют память и процессор так, что наш код этим не управляет, — например, среды со сборщиком мусора. Тогда любой тревожный сигнал Claude мог проследить до конкретного бага или конкретного решения в устройстве системы.
Но честно: всё это сработало потому, что наши флагманские модели в последнее время сильно выросли (я использовал внутреннюю исследовательскую модель, примерно уровня Claude Fable 5.2). По нашему опыту, они теперь могут неделями держаться за одну цель в таком забеге — именно это и позволило дожать масштаб запуска в сжатые сроки.
Хаос-цикл
Несколько тысяч внутренних пользователей на одной машине ничего не говорили о том, переживёт ли сервис запуск, а реального трафика запуска у нас, очевидно, не было.
Мы хотели настоящих доказательств, чтобы решить, как быстро можем раскатываться. Поэтому 4 сентября, примерно за две недели до релиза, я посадил Claude за руль тестового кластера, который повторял продакшен и получал больше миллиона синтетических документов в день, и велел ломать ключевые компоненты нарочно. А потом… я просто оставил его работать (полная стоимость — в конце статьи).
Настройка была простой. Цикл — это сессия в Claude Code, которую я оставил работать: выбери сценарий, прогони стенд, прочитай телеметрию, предложи правку, выкатывай на staging, повтори. Эта сессия работала координатором и раздавала большую часть работы суб-агентам (вспомогательным агентам под её управлением). В самую загруженную неделю это означало примерно 11 суб-агентов одновременно, в пике — 30. Координатор также общался с нашей внутренней версией Claude Tag (бета) через Slack MCP, чтобы перенять опыт команд Anthropic, которые уже масштабировали похожие сервисы. Их агенты проверяли наш подход к масштабированию на грабли, на которые те уже наступали.
Веселье было в выборе сценариев, которые я сам считал параноидальными:
- 10 миллионов новых документов за один день
- 22 000 живых соединений, переподключающихся одновременно
- Один горячий документ с сотнями зрителей, сервер, убитый прямо во время загрузки документа, и зависшая база данных
Каждая итерация выглядела одинаково. Наш тестовый стенд выбирал функцию вроде создания документов и давил её до насыщения. Claude читал телеметрию через Datadog MCP и возвращался с коротким списком вариантов и рекомендацией.
Если правку было легко отменить, Claude писал её, выкатывал на staging и повторял тест. У нас была телеметрия по каждой операции сервиса. Каждый запрос к базе, например, сообщал своё имя и сколько строк просканировал против того, сколько вернул, — так Claude мог заметить плохой запрос и переписать его.
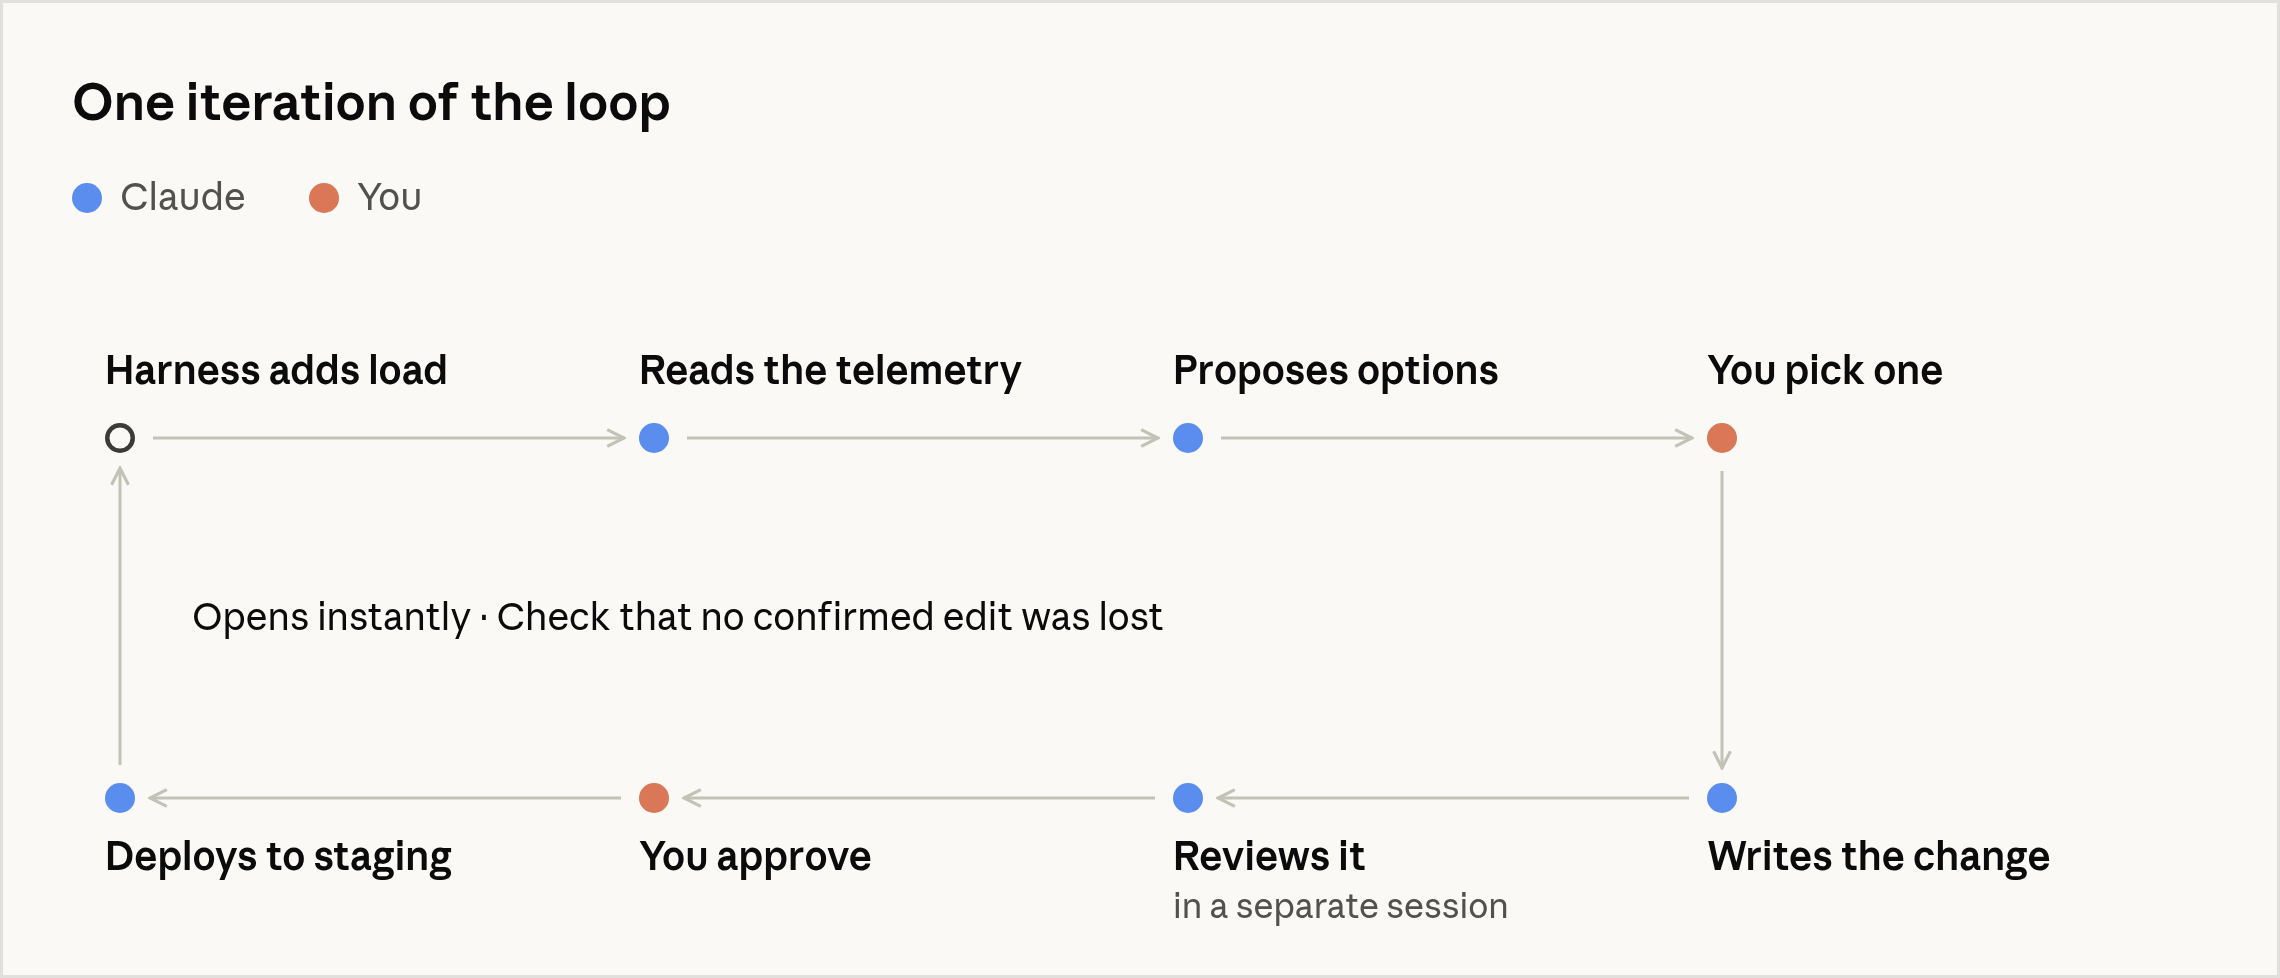
Одна итерация цикла: два решения принимает человек
До запуска цикла я сказал Claude, какие решения требуют моего одобрения: по сути всё, что трудно откатить, — смену схемы базы или раскладки ключей, смену того, как документ хранится и собирается.
Натыкаясь на такое, Claude останавливался и спрашивал меня — обычно с рекомендацией, которую я в итоге одобрял. Изменения схемы базы — классический случай, где я хочу консультацию: разумных ответов обычно несколько, а смена направления почти всегда болезненная.
И на всём протяжении тестов Claude должен был соблюдать два инварианта (правила, которые нельзя нарушать):
- Документы открываются почти мгновенно (даже с длинной историей)
- Если сервер подтвердил правку, тесты обязаны показать, что правка на месте
Сделать сервис понятным для Claude
Мой коллега Феликс Ризеберг недавно написал туториал про амбиции с моделями. Его главная идея — поднимать «высоту» запроса: просить у Claude результат, а не отдельные задачи.
То есть вместо «почини вот этот краш» — «сделай приложение, которое не падает». (Наши собственные приложения ещё не там, но именно так мы двигаемся дальше.) Чтобы работать на такой высоте, нужно устроить код так, чтобы Claude сам мог вытаскивать отчёты о падениях и гонять стенд, который воспроизводит каждый краш и проверяет исправление.
Для нас результатом был сервис, который переживёт запуск. Для этого мы сделали две вещи, чтобы сервис был максимально «читаем» для Claude:
- Диагностический цикл. Claude на каждой итерации читал телеметрию и дописывал всё, что считал недостающим.
- Понятные технологические выборы. Мы подобрали среду исполнения и зависимости так, чтобы любое число, которое измерил Claude, возвращалось к коду, который написали мы.
Диагностический цикл
Каждую итерацию Claude читал телеметрию и дописывал то, чего не хватало. Писать телеметрию руками скучно, поэтому на практике её обычно добавляли уже после того, как что-то ломалось. Теперь Claude пишет её по ходу.
Лучший пример — память.
В начале прогона один большой документ занимал около 3 ГБ на своём поде (не самое приятное число, которое можно увидеть). Первая попытка Claude — уменьшить один из наших кэшей, чтобы сервер выкидывал документы раньше. Следующий прогон показал: память на самом деле сидит в отдельном кэше внутри одной из наших зависимостей, и Claude отменил изменение.
Дальше Claude сужал круг всё более мелким профилированием памяти. В итоге выяснил: каждое нажатие клавиши копировало документ в несколько разных структур данных, добавляя по несколько мегабайт каждый раз. Claude перевёл эти структуры на copy-on-write (копирование при изменении) — теперь они делят одну ссылку вместо собственной копии у каждой.
После примерно трёх дней итераций тот же документ упёрся в ~180 МБ, а наша оценка потребностей на запуск упала с более чем 500 подов с увеличенной памятью до примерно 50.
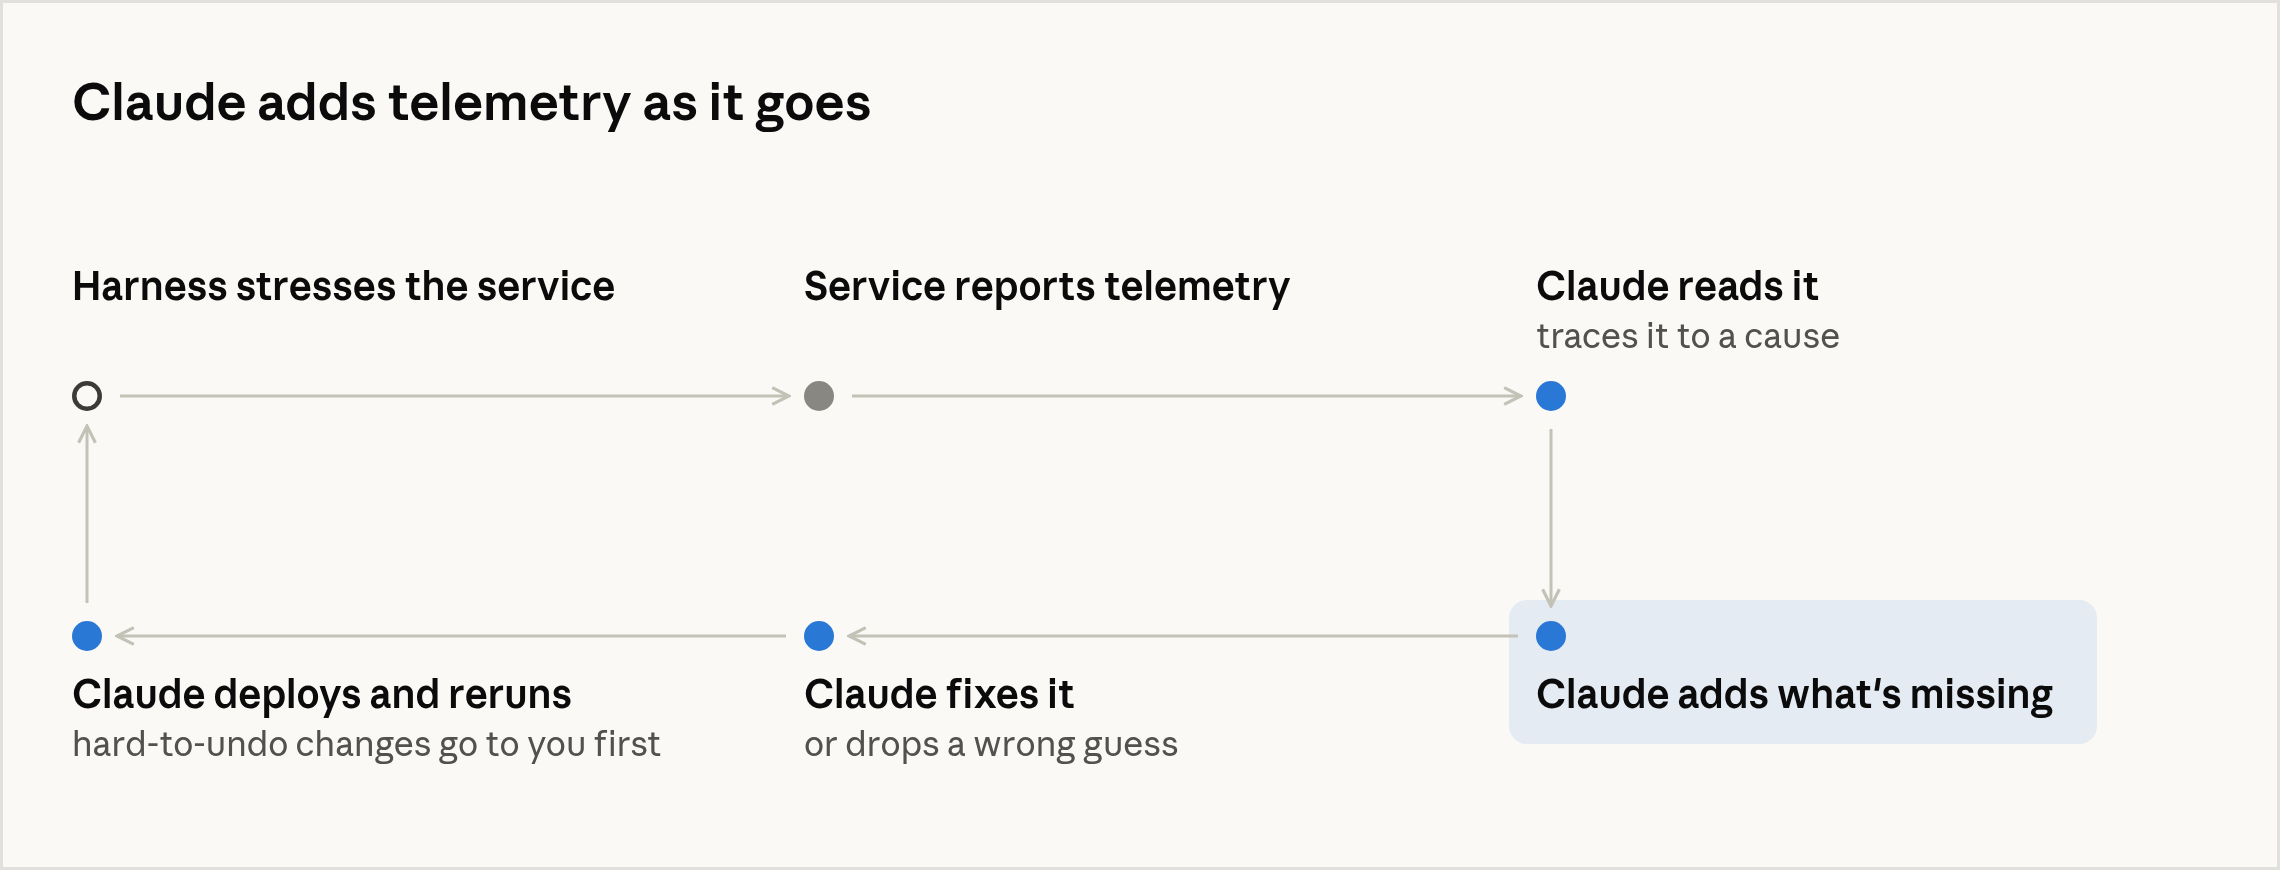
Диагностический цикл
Понятные технологические выборы
Мы были разборчивы в среде исполнения и зависимостях сервиса. Хотели, чтобы любое измеренное число возвращалось к нашему коду.
Потому что наши модели лучше всего «карабкаются в гору» по чистому сигналу. От сборщика мусора мы ждали шума: память и задержки пляшут по расписанию сборщика, а не по нашему.
Два выбора помогли больше всего.
- Мы написали сервис на Rust. Без сборщика мусора вся память документа сидит в структурах, которые определили мы. Когда она росла, Claude мог ткнуть в виновника, поменять его и на следующей итерации проверить, ушла ли память. В Anthropic отличные инструменты и для Go, но мы не устраивали сравнение двух языков — это просто наш опыт с Rust. Что я оценил после прошлой работы с Go: как мало приходится думать о памяти, которая висит после того, как код с ней закончил.
- Мы держали зависимости на минимуме. Каждая библиотека приносит структуры данных, которые мы не писали и не можем легко учесть. Немного действительно нужных мы вендорили (скопировали их код к себе), чтобы читать и мерить их самостоятельно.
Rust тяжело даётся людям, и несколько лет назад это перевешивало бы чашу весов. Claude пишет его и большинство других языков нормально, так что теперь это значит куда меньше.
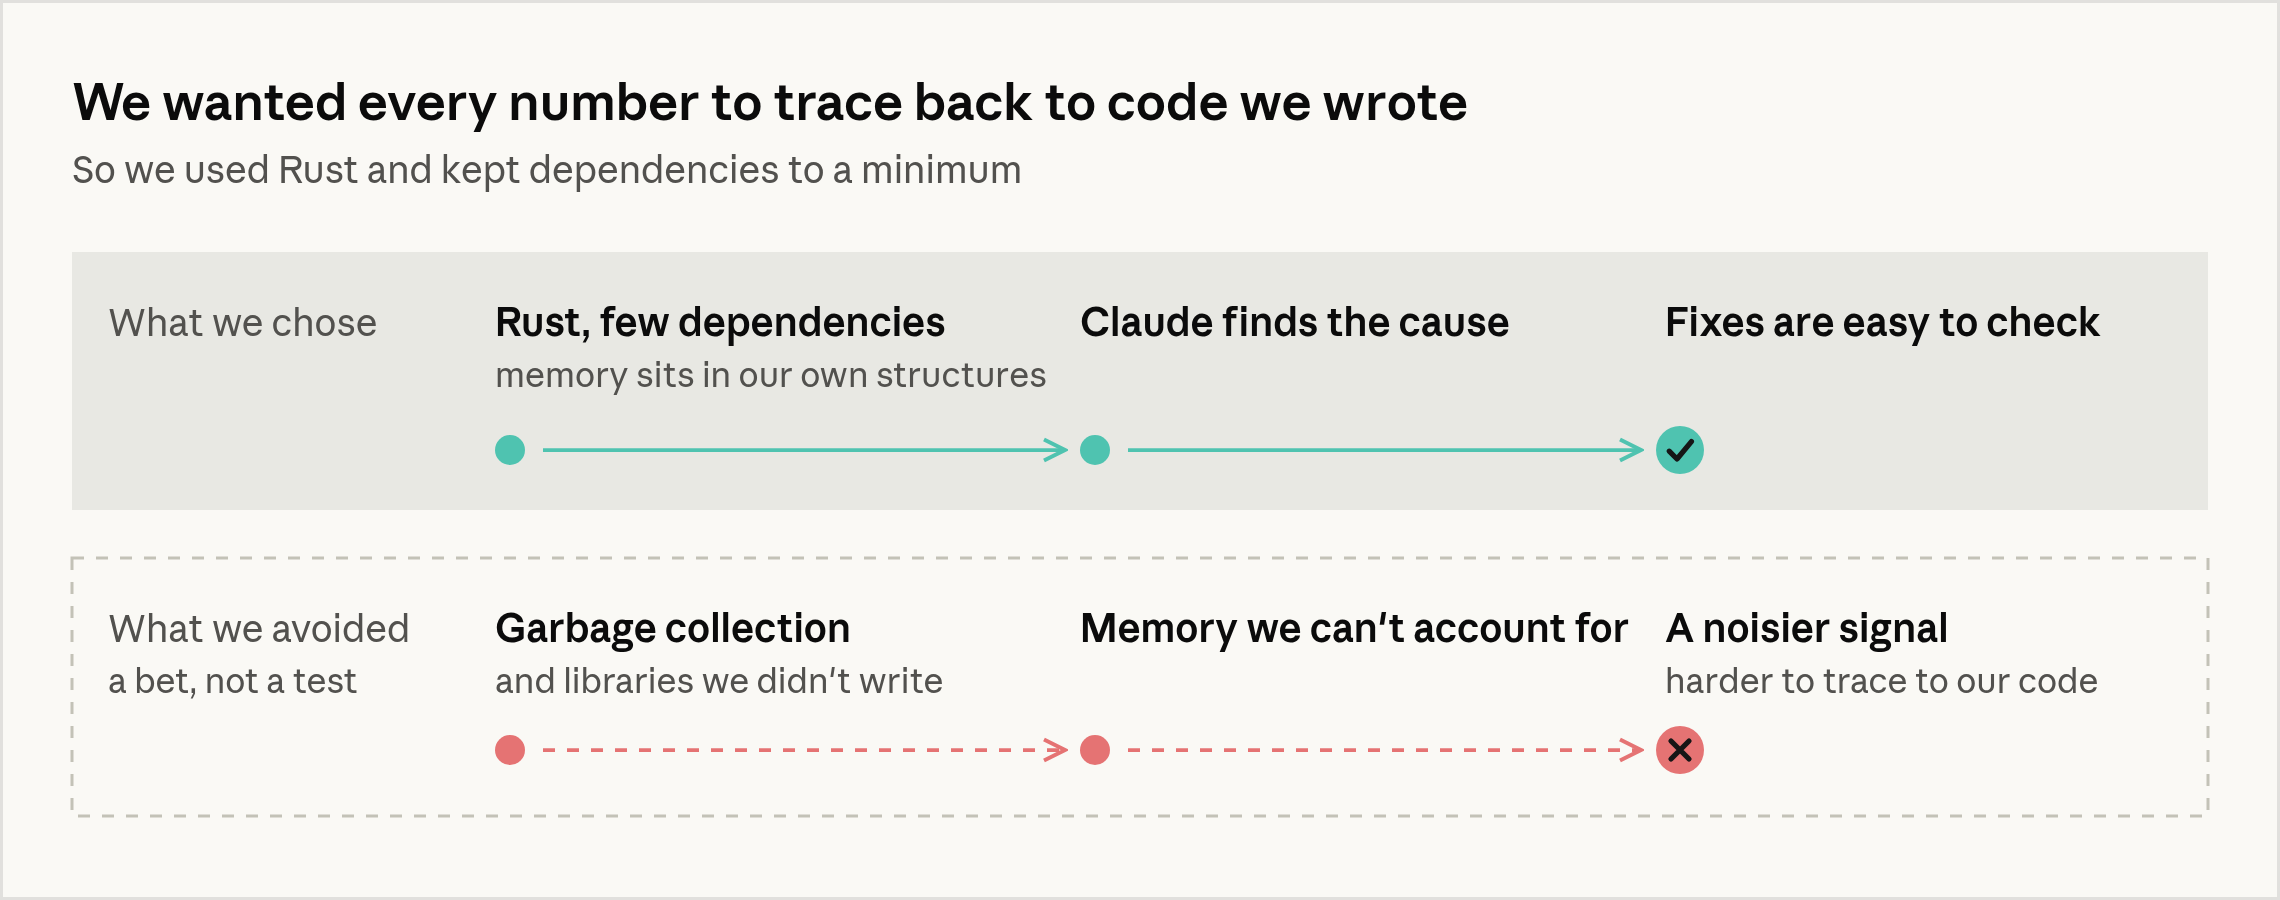
Понятные технологические выборы: память, которую объясняет наш код, и память, которую не объясняет
Неделя запуска
Сервис держал масштаб запуска. Первый миллион документов появился примерно за 30 часов, к 22 сентября мы перевалили за 4,6 миллиона. В сентябре мы выкатывали в прод 629 раз и ни разу не откатывались.
Неделя запуска ощущалась странно знакомо. Claude отлично воображает, как сервис может упасть, и заранее отработал большинство сценариев. Семь из десяти сценариев, что мы репетировали на staging, реально случились в проде. К тому моменту стенд уже прогонял staging через большую часть этого, и Claude выкатил исправления за runtime-флагами (переключателями, которые можно включить на живом сервере без нового деплоя). Когда часть инфраструктуры упиралась в потолок, мы обычно просто щёлкали флагом.
Почему это работает сейчас
Несколько месяцев назад это, скорее всего, не сработало бы. Старые модели нормально читали телеметрию через MCP-сервер, но через десять-двадцать итераций длинного цикла начинали забывать, что мы оптимизируем, и мне приходилось заново формулировать цель. В Anthropic это называют дрейфом цели.
Новые флагманские модели собраны для долгой работы. Claude держал все наши инварианты через множество сжатий контекста (когда длинная история диалога ужимается, чтобы вместиться в лимит), и повторять их мне ни разу не пришлось.
Мы не одни. Vercel разогнала Turborepo до 96% похожим циклом с агентом под присмотром.
Сколько это стоило
По прайс-листу API Claude Fable 5.2 (на ноябрь 2026) я сжёг примерно $125 000 инференса с конца августа до дня запуска. Пару лет назад работу такого масштаба, прикинул бы я, делала команда инженеров месяца шесть.
Большая часть ушла на чтение телеметрии, написание предложений, генерацию исправлений и ревью кода.
Пара замечаний о цене:
- Наш запуск был особенно большим. Заметный кусок денег ушёл в инфраструктуру, которая имеет смысл только в таком масштабе, и на рассуждения о ней уходило больше инференса. Claude приходилось куда сильнее думать о том, как растущий набор сервисов стыкуется друг с другом и какими способами всё это может упасть.
- Я ещё и жёг токены, разбираясь с самим процессом. Цикл крутился без остановки, пока я экспериментировал с настройкой. Зная то, что знаю сейчас, думаю, мы бы потратили примерно вдвое меньше.
Как попробовать
Это работает и для гораздо меньших сервисов, и стоить должно сильно дешевле.
Для грубой прикидки я оценил классический стек маленькой команды: пара Kubernetes-нод нормального размера и инстанс Postgres. Потом прошёлся по изменениям, которые я приземлил с конца августа до дня запуска, и убрал работу, которой такая настройка не требует:
- стыковку с нашими внутренними сервисами
- клиентскую и продуктовую работу, перемешанную с работой над масштабом
- работу на многих подах
- тонкое ограничение частоты запросов (rate limiting)
Осталась примерно треть изменений.
Масштабировав расходы до этой трети и выкинув ошибки, которые я делал, пока настраивал процесс, я оцениваю двухнедельный забег вроде этого в $3 000–$10 000 по тому же прайсу (я это реально не запускал, так что это грубая прикидка).
Шаги ниже исходят от одного инженера с Claude Code, staging-окружением и сервисом мониторинга. Координатор и суб-агенты ускоряли процесс, но если они жгут слишком много токенов в час, возврат к одному агенту тоже должен неплохо работать. Если хочешь попробовать:
- Дай Claude доступ к телеметрии. У большинства сервисов мониторинга есть MCP-сервер, которым Claude может пользоваться.
- Попроси Claude написать нагрузочный скрипт, который бросает в staging-копию сервиса в десять раз больше реального трафика и ломает вещи нарочно. Убить инстанс, подвесить базу, задеплоить посреди пика — хорошие точки старта. Дальше пусть Claude чинит всё, что падает.
- Выбирая стек, клонись к тому, что Claude проще всего мерить. Для нас это Rust и как можно меньше зависимостей.
- До старта выпиши свои главные технические инварианты и отдай их Claude.
- На всём, что трудно откатить, пусть Claude останавливается и даёт несколько вариантов с чёткой рекомендацией.
Огромное спасибо команде Docs, которая приземлила тысячи правок редактора в те же три недели, и командам платформы и хранилища, которые построили всё, на чём это стоит.
Читать дальше. Как мы сделали claude.ai в 3 раза быстрее за две недели (claude.dev) · Стенд для каждой задачи: динамические рабочие процессы в Claude Code (claude.dev) — о дрейфе цели.
Фактчек
- Механика цикла опирается на реальные возможности Claude Code. Долгие сессии, суб-агенты, подключение внешних инструментов через MCP и сжатие контекста в длинных диалогах — всё это существует в Claude Code, так что описанную схему реально собрать.
- «Дрейф цели» совпадает с известной проблемой. То, что модели в длинных агентных сессиях теряли нить после десятков итераций, — это общий опыт пользователей, а не только рассказ автора. Новые модели действительно держат контекст лучше, хотя «неделями без напоминаний» — это уже заявление самой Anthropic.
- Аргумент про Rust технически честный. Без сборщика мусора память действительно лежит в ваших структурах, и её проще проследить до конкретного кода. Но сравнения с Go автор не делал и сам это признаёт — это выбор по убеждению, а не результат замеров.
- Цифры запуска проверить нечем. 4,6 млн документов, 2 млрд запросов, 60 ошибок, 629 деплоев, 50 подов — внутренние данные Anthropic, извне их не подтвердить. «Всего 60 ошибок» звучит эффектно, но technically это счётчик только серверных ошибок, а не всех проблем — обычные ошибки пользователя туда не попадают.
- Claude Fable 5.2 — модель, которой я не знаю. Статья датирована ноябрём 2026 года; публичной модели с таким названием в моих данных нет, автор называет её внутренней. Проверить нечего — берём на слово.
- Цены — оценки автора. $125 000 за инференс и $3 000–10 000 для маленького сервиса посчитаны по внутреннему прайс-листу, который не опубликован. Для малого сценария автор сам честно оговаривает: он его не запускал.
- Vercel и Turborepo на 96%. Это чужое заявление со ссылкой на их блог; подтвердить цифру я не могу.
- Феликс Ризеберг — реальный разработчик, известный по Electron и работе в Slack. Его текущее место работы и содержание конкретного туториала по тексту не проверить.
Как применить
- Подключи метрики к Claude Code. У большинства сервисов мониторинга (Datadog, Sentry и подобных) есть MCP-сервер. Добавляется через
claude mcp add, проверить подключение — командой/mcp. - Закажи нагрузочный скрипт с ломанием. Попроси Claude написать скрипт, который гонит через staging-копию в десять раз больше реального трафика и нарочно ломает: убить инстанс, подвесить базу, задеплоить посреди пика. Дальше цикл: нашёл проблему — предложил фикс — выкатил — перепроверил.
- Выпиши инварианты до старта. Два-три правила, которые нельзя нарушать (у автора: документ открывается мгновенно, подтверждённая правка не теряется). Отдай их Claude в начале — длинные сессии без них расползаются.
- Договорись о границах. Всё необратимое (схема базы, формат хранения) — стоп, варианты и рекомендация от агента, решение принимаешь ты. Остальное Claude делает сам.
- Выбирай стек, который агент может измерить. Минимум зависимостей, предсказуемая память без фоновых процессов, которые размывают картину. Если метрика всегда указывает на ваш код — цикл сходится быстро.
- Следи за расходом. Автор потратил $125 000, но половину сжёг на эксперименты с самим процессом. Если суб-агенты жгут токены слишком быстро — вернись к одному агенту, по словам автора, это работает почти так же.
Кому полезно: бэкенд-командам перед высоким трафиком и соло-разработчикам с небольшим сервисом — по прикидке автора, двухнедельный забег на маленьком стеке обойдётся в $3 000–10 000, а не в $125 000.