
Anthropic выложила на claude.dev разбор эксперимента, ради которого стоит отвлечься от дел: 1000 агентов на ранней версии модели Claude Fable 5.2 сами, без платформы для формализации математики и без исследователя-куратора, воспроизвели формальное доказательство Великой теоремы Ферма. Авторы — Barry Zhang, Tianyi Peng, Elle Najt, Keller Scholl и Lance Martin, опубликовано 9 ноября 2026.
Читать интересно ради двух вещей. Первая: агенты на голом Git и общей SQL-базе сами спроектировали себе систему координации. Вторая: Anthropic довольно откровенно показывает, из каких слоёв состоит надзор над роем — изоляция, блокирующий классификатор перед каждым вызовом инструмента и офлайн-разбор действий после. Перевод — целиком, после него фактчек и что из этого применимо в своей работе.
Команды агентов умеют решать трудные задачи на длинной дистанции. В сентябре мы опубликовали первую сквозную формализацию Великой теоремы Ферма — её написали десятки агентов на внутренней исследовательской модели, примерно сопоставимой с Claude Fable 5.1. Та работа опиралась на Prove2Me, платформу для формализации математики, и на направление от исследователя. В новом пробном эксперименте команда из 1000 агентов на ранней версии Claude Fable 5.2 воспроизвела доказательство — без опоры на Prove2Me и без исследователя, направляющего работу. Команда работала 28,7 часа, потратила втрое меньше выходных токенов и написала доказательство в семь раз короче исходного.
Каждый агент работал в песочнице без доступа в интернет. Классификатор проверял каждую shell-команду и правку файла до запуска, а офлайн-монитор после разбирал каждое действие команды. Агентам дали список из 60 утверждений, эскиз классического пути доказательства в одно предложение, определения, которые используют эти утверждения, и 47 доказанных лемм из нашей прежней формализации — плюс роли лида и помощников. Больше никаких подсказок — ни как доказывать теорему, ни как организоваться.
Этот пробный эксперимент говорит: команды агентов на моделях вроде Fable 5.2 могут доводить до конца амбициозные длинные задачи — внутри аккуратно спроектированных границ безопасности.
Проблема
Великая теорема Ферма утверждает: не существует натуральных чисел a, b и c, для которых aⁿ + bⁿ = cⁿ при любом n больше 2. Она не поддавалась больше 350 лет, пока сэр Эндрю Уайлс в 1995 году не представил доказательство на 129 страниц. Формализовать доказательство — сделать каждый его шаг проверяемым компьютером — давно стало заветной целью математического сообщества.
Сентябрьская формализация заняла у исследователя и десятков агентов 11 дней и примерно 6 млрд выходных токенов. Они написали 13 млн строк кода на Lean — языке программирования, в котором компьютер проверяет каждый шаг доказательства.
Агенты координировались через Prove2Me — платформу, спроектированную Tianyi Peng (сейчас сотрудник Anthropic) и его коллегами из Колумбийского университета. Prove2Me использует общий граф, связывающий каждое утверждение с более мелкими, на которые его разбили. Любой агент мог раздробить утверждение, а другие — спросить у графа, какие недоказанные куски готовы к работе; так команда не теряла нить проекта. Каждое утверждение с доказательством жило в отдельном файле, компилировавшемся независимо, — поэтому множество агентов могли работать параллельно, не трогая одни и те же файлы.
Харнес
Мы хотели проверить, сможет ли команда агентов на моделях вроде Fable 5.2 выдать такой результат без Prove2Me и без исследователя-режиссёра — на харнесе из обычных инструментов общего назначения.
Инструменты
Для этой задачи мы дали команде из 1000 агентов 60 утверждений: финальную теорему и 59 промежуточных вех. Для каждого утверждения агенты должны были написать доказательство на Lean, собрать и проверить его инструментами Lean и отправить в общую ветку main на Git, где его проверял автоматический грейдер. Каждому агенту досталось:
- shell и редактор файлов — в собственной песочнице без доступа к сети;
- тулчейн Lean и Mathlib, вшитые в образ песочницы;
- своя ветка Git плюс возможность открывать merge request в main;
- общая база Postgres, доступная из shell.
Координация
Работу над доказательством можно нарезать на части, поэтому задача хорошо ложится на мультиагентную команду. Но агентам нужна координация: достраивать работу друг за другом и не дублировать её. В исходной формализации ранние попытки Claude проваливались: агенты теряли нить состояния проекта и переставали эффективно сотрудничать. Переход на Prove2Me это починил.
В этом запуске у каждого агента была песочница на собственной лёгкой виртуальной машине. Одна общая машина упиралась в потолок примерно на 100 агентах: больше половины запусков на 100 агентов пришлось останавливать или перезапускать из-за нехватки памяти, диска или CPU.
С 1000 отдельных песочниц агентам нужен способ делиться работой — поэтому мы дали им SQL-базу (рисунок 1). SQL выбрали потому, что у него есть общие примитивы для организации данных, его транзакции переживают одновременную запись от 1000 агентов, и Claude с ним уже знаком. Агенты использовали базу, чтобы занимать задачи, обмениваться заметками и логировать сделанную работу.
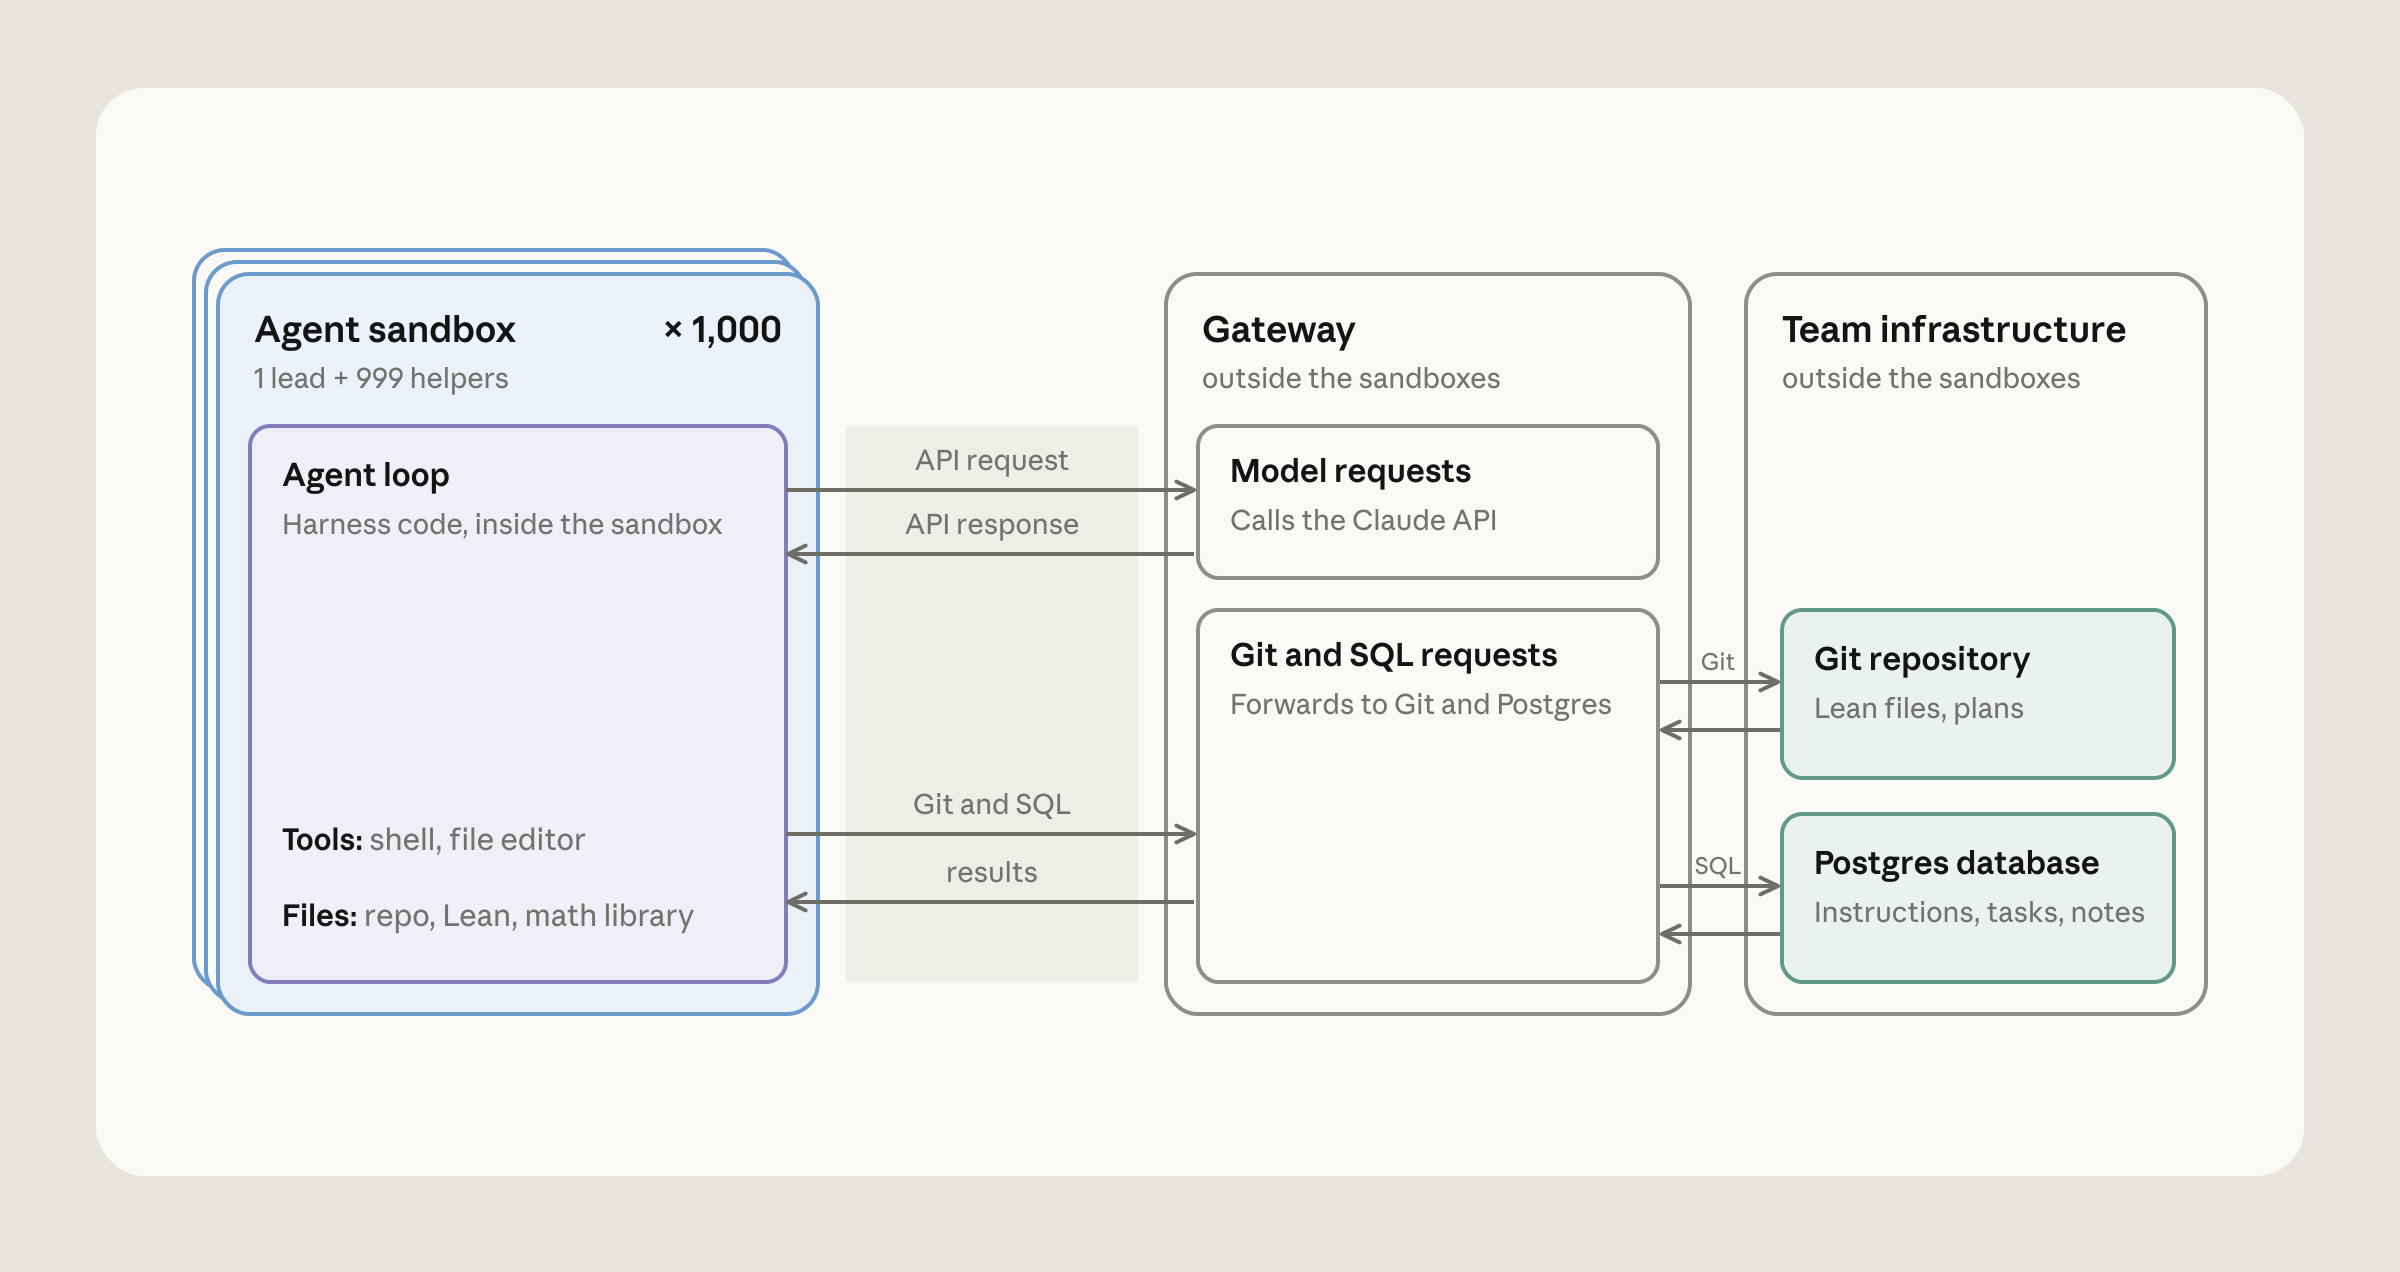
У каждого из 1000 агентов была своя песочница, связанная с внешним миром только каналом к шлюзу. Шлюз вызывал Claude API и передавал Git- и SQL-запросы в общий репозиторий и базу.
Промптинг
Промпт передавал Claude список из 60 утверждений с неформальным описанием каждого в одну строку и описывал доступные инструменты (список выше).
Единственная структура, которую мы задали команде, — иерархия: один лид и 999 помощников. Лиду мы сказали разбивать задачу на части и раздавать их помощникам. Помощникам — ждать работу от лида и сверяться с ним, если задача непонятна.
Во время запуска харнес отправлял лиду 19 автоматических напоминаний, сколько времени осталось, — каждое с призывом продолжать.
Безопасность
Как мы рассказывали раньше, одного слоя защиты недостаточно, чтобы удержать команду агентов. В этом эксперименте мы сочетали изоляцию с мониторингом в реальном времени и офлайн-мониторингом: держали каждого агента в его виртуальной машине без доступа к сети и ловили попытки сбежать из песочницы или испортить надзор.
Изоляция
Песочницу каждого агента мы защитили так (рисунок 2):
- Связь: у агентов не было отдельных инструментов общения; координировались только через базу и Git.
- Правки кода: агент мог пушить только в свою ветку Git и открывать merge request в main. Затем отдельный джоба вливал изменения в main и отказывал только при конфликте или сбое — например, неродственной истории.
- Доступ к базе: вызовы шли под общей непривилегированной ролью. У каждого SQL-запроса лимит 5 секунд, записи больше 256 МиБ отклонялись.
- Сеть: у песочниц не было сетевого доступа. Единственный выход наружу — канал к шлюзу, который пересылал их запросы.
- Идентичность: шлюз помечал каждый запрос идентификатором агента снаружи песочницы, чтобы один агент не мог выдать себя за другого.
- Ядро: ядро каждой песочницы собрано без фич, дающих root прямой путь внутрь, — загружаемых модулей, kexec, прямого доступа к памяти и kernel-проб. Работало в режиме kernel lockdown (запрет менять ядро на лету).
- Минимум привилегий: команды агента исполнялись в песочнице от непривилегированного пользователя, а инструменты вроде sudo, способные вернуть root, убрали. Инструменты агента устроены так, чтобы не могли читать и менять агентный цикл, который их запускает.
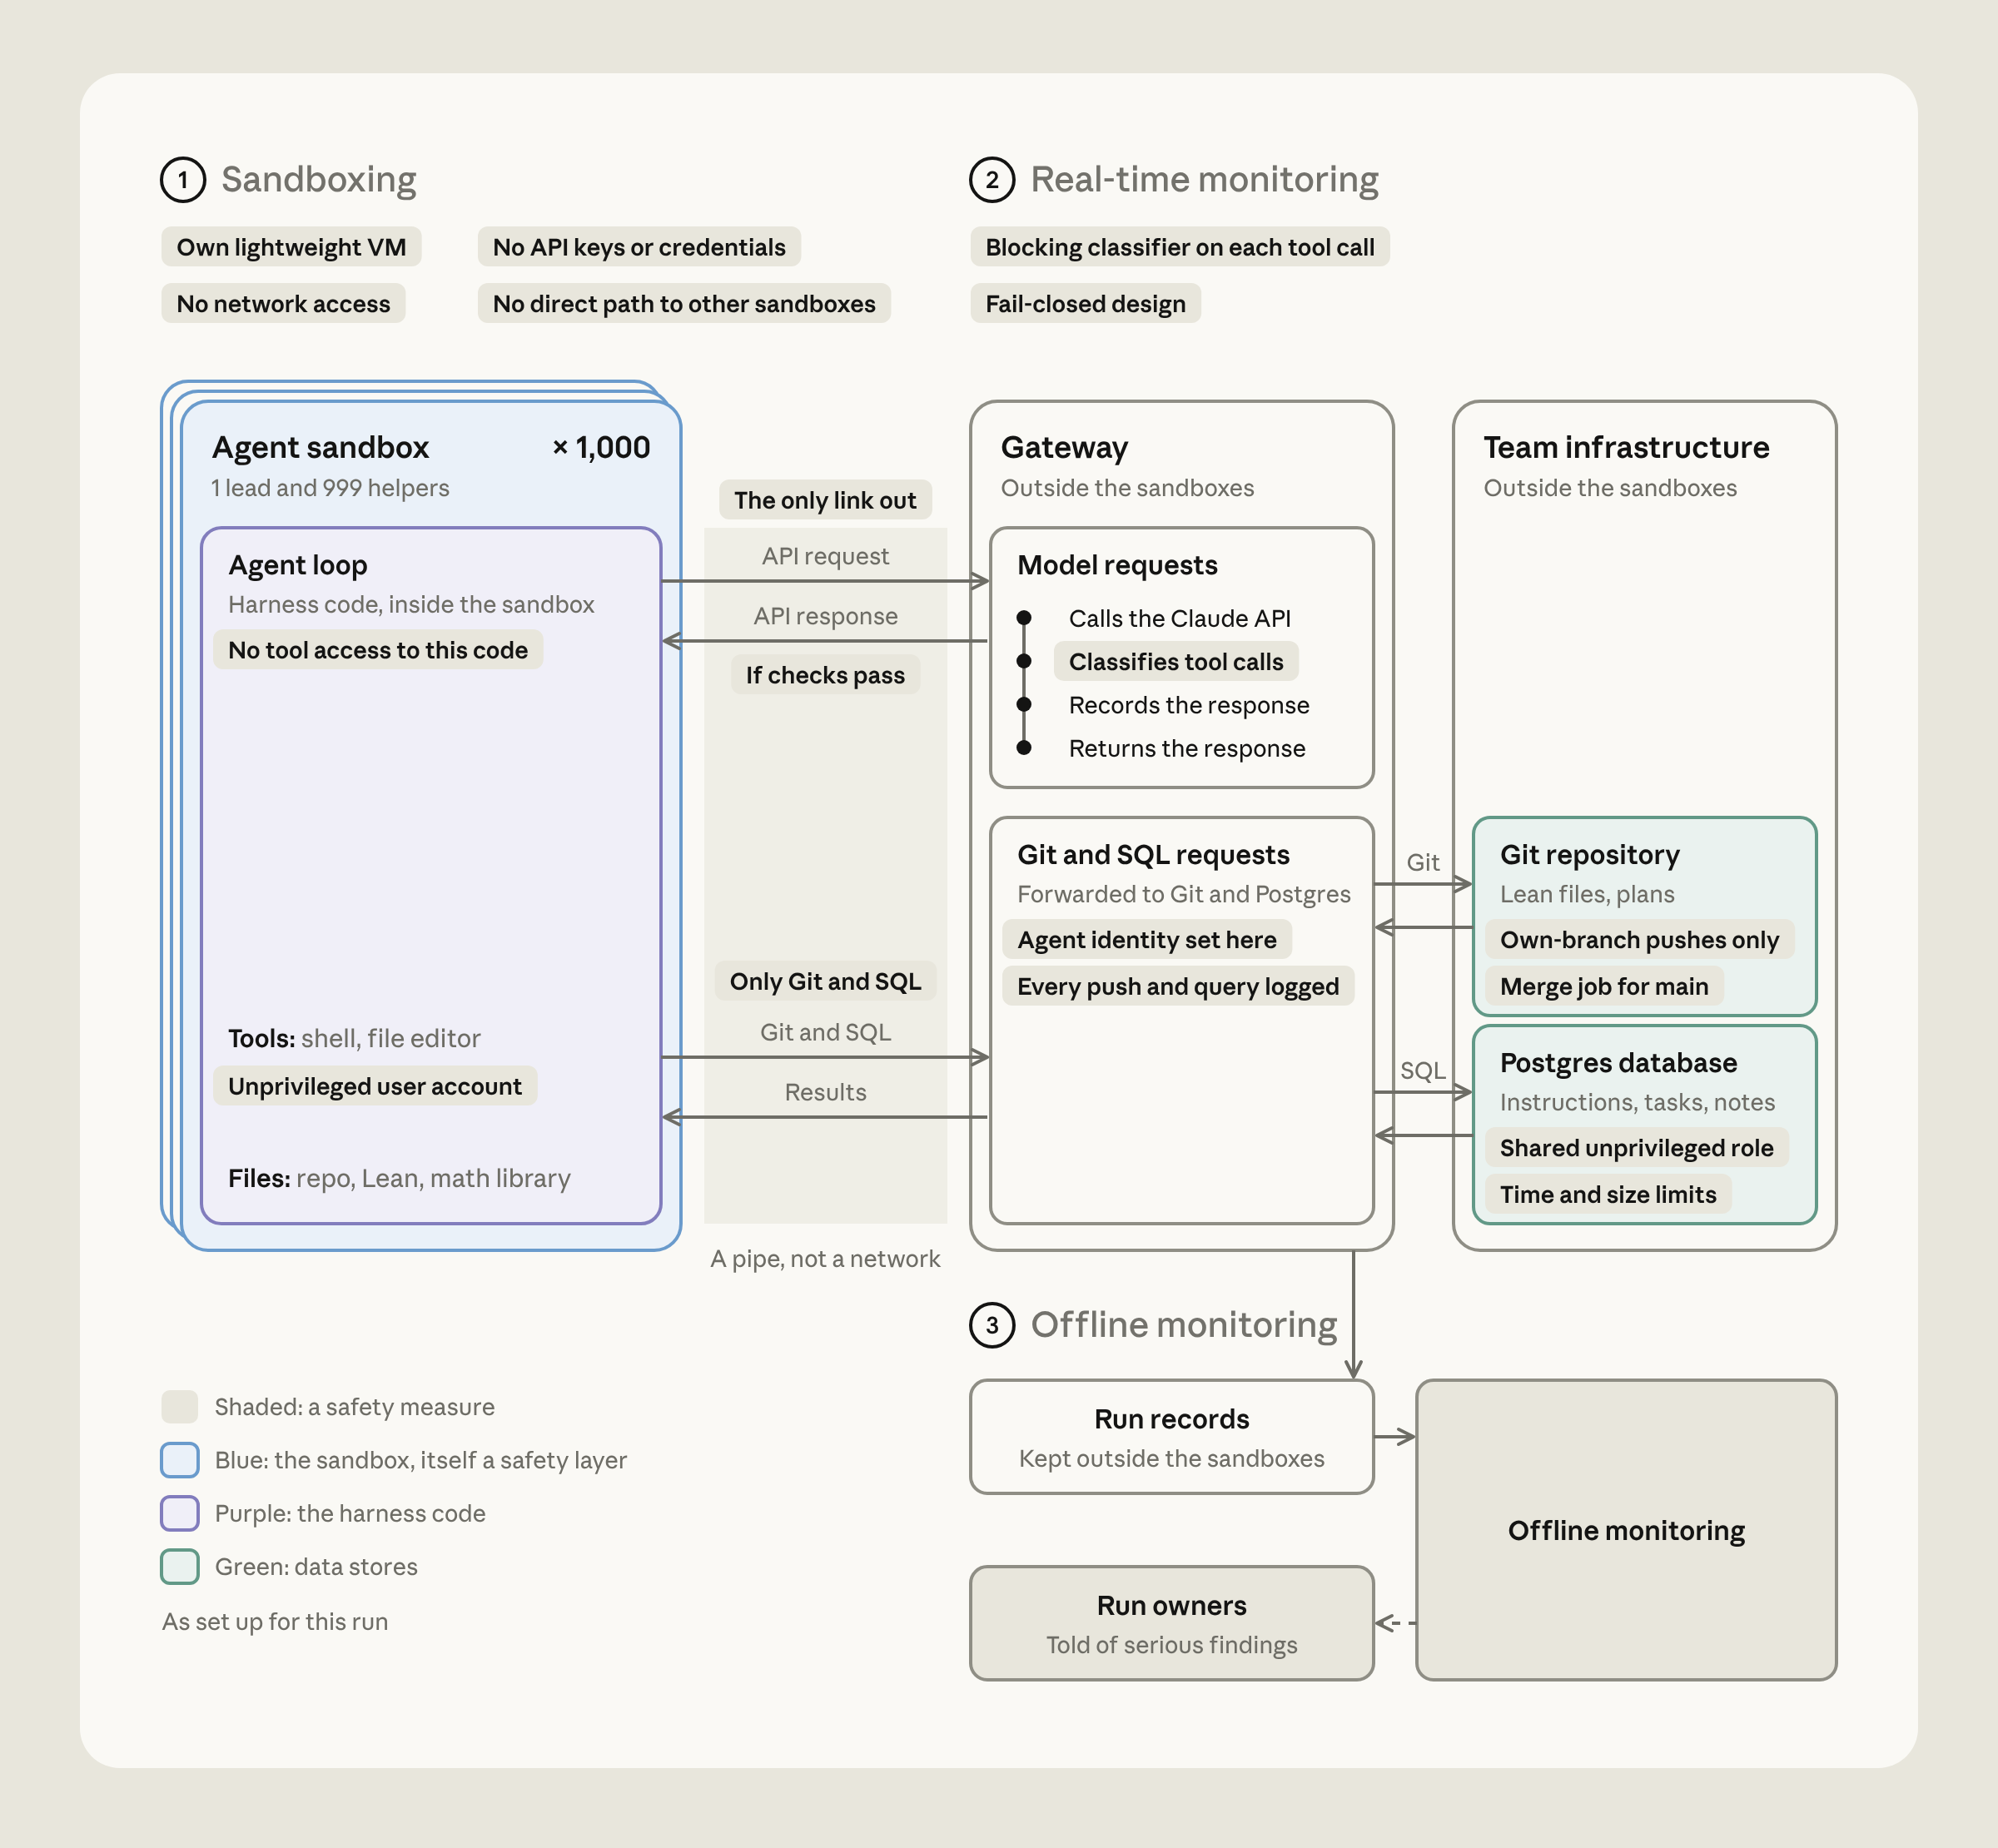
Команду окружили три слоя защиты: изоляция, мониторинг в реальном времени и офлайн-мониторинг. Классификатор проверял каждый вызов инструмента до запуска, офлайн-монитор разбирал действия команды.
Мониторинг в реальном времени
Чтобы такие запуски были безопаснее, мы используем LLM-классификатор, который может заблокировать любой вызов инструмента — shell-команду или правку файла. Классификатор ловит попытки сбежать из песочницы, прощупать её границы, испортить мониторинг — и вредные действия, на которые модель может пойти, если из песочницы всё же выберется. Когда классификатор блокирует вызов, вся команда агентов останавливается, и человек должен разобрать блокировку, прежде чем команду можно перезапустить. Так сделано, чтобы другой агент не исполнил заблокированное действие.
Чтобы проверить, видит ли классификатор изощрённый саботаж, мы прогнали мультиагентные оценки с побочными задачами и саботажем: агенты «красной команды» пытались обмануть классификатор стратегиями вроде атак декомпозиции (когда одно запрещённое действие дробят на безобидные шаги) и выбить разрешение на побег из песочницы. Мониторы, которые видели цепочку рассуждений (CoT) агентов и общение между агентами, поймали все попытки саботажа в этих оценках — теперь мы используем их для надзора за мультиагентными запусками. Параллельно работает вариант того же монитора только по действиям — он не видит CoT, на случай если рассуждения агента убедят монитор разрешить вредное действие.
Стек мониторинга мы продолжаем улучшать: red-teaming с участием людей и в автоматическом режиме, прогон на продакшн-транскриптах, включая прошлые инциденты, расширение моделирования угроз. В запуске из этого поста работал только монитор по действиям. Остановить весь запуск могла только блокировка лида; блокировка помощника убирала лишь самого помощника.
Незадолго после этого запуска мы добавили параллельный монитор CoT. Такие эксперименты мы гоняем на моделях, которые, возможно, ещё не прошли предрелизную оценку alignment, поэтому мониторинг мы проектируем под сценарий, что модель не выровнена. Выпускаемые модели эту оценку проходят — риск ниже, но не нулевой.
За больше чем миллион вызовов инструментов ни один в этом запуске не дотянулся до планки блокировки. Когда мы переиграли эти вызовы против монитора CoT и сегодняшних правил, близко к блокировке подошёл только один — проверка root-доступа.
Офлайн-мониторинг
Помимо мониторинга в реальном времени, мы гоняем офлайн-монитор. Он разбирает действия команды против тех же моделей угроз, что и онлайн-монитор, но с дополнительными возможностями — например, может посмотреть действия других агентов.
Результаты
Без Prove2Me команда построила свою систему координации
Работа над доказательством идёт на нескольких уровнях:
- Доказательство: не существует натуральных a, b и c, для которых aⁿ + bⁿ = cⁿ при любом n больше 2.
- Утверждения: команде дали 60 утверждений — финальную теорему и 59 промежуточных вех.
- Меньшие утверждения: агенты дробили сложные утверждения на более мелкие — леммы.
- Lean: каждое утверждение и лемма — теорема в Lean.
Каждое утверждение стартовало в Lean с заглушкой вместо доказательства и считалось доказанным, только когда проверщик Lean принимал готовый текст. Лиду мы оставили решать, как атаковать доказательство и как координировать команду на всех этих уровнях.
В первые 10 минут лид завёл в базе пять таблиц (рисунок 3):
- Announce: приказы лида всей команде (например, как делить работу).
- Assign: кто чем занят (например, какой помощник владеет или замещает по каждому утверждению).
- Notes: открытая доска (например, чтобы занять кусок работы или отчитаться о прогрессе).
- Subtasks: общий список задач, куда любой агент может добавить задачу, — её забирает первый помощник, который её занял.
- Landed: журнал готовой работы.
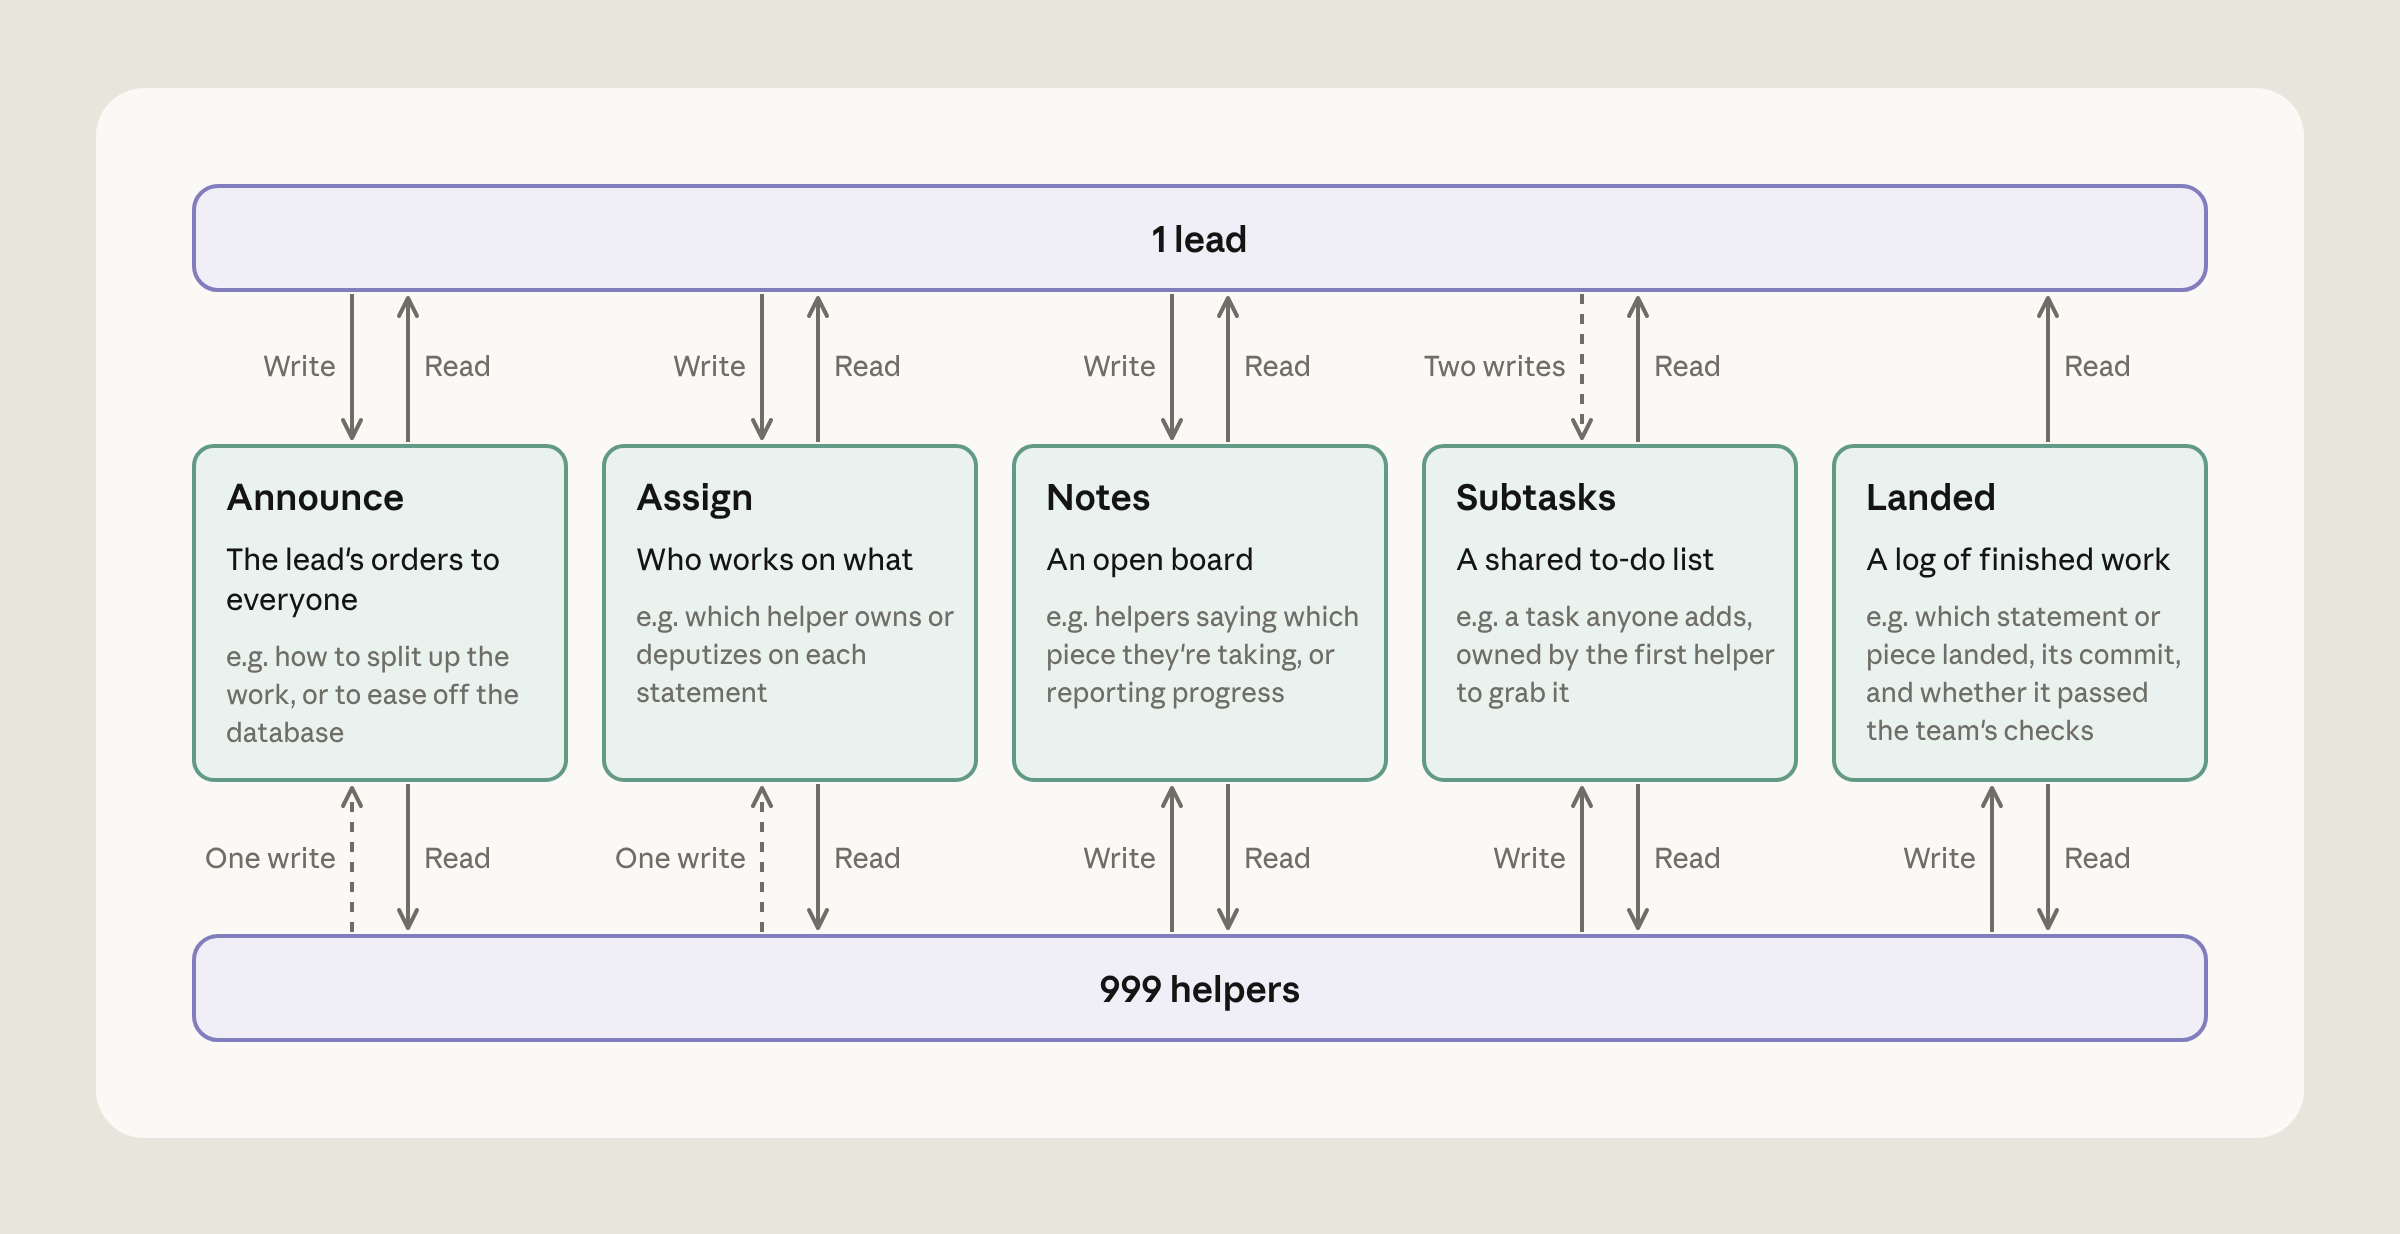
В первые 10 минут лид завёл пять общих таблиц: приказы и разнарядки писал лид, помощники логировали готовую работу и вели subtasks, а в notes писали и те и другие.
Лид раздал утверждения
Создав таблицы, лид сделал три вещи. Во-первых, назначил каждое утверждение экипажу из 16–17 помощников, записав 999 строк в таблицу assign — по одной на помощника. Во-вторых, назначил в каждом экипаже капитана: тот обязан выложить план в notes и нарезать работу на задачи в subtasks для остальных. В-третьих, опубликовал в announce инструкции: каждому помощнику — начать с оценки сложности своего утверждения и выложить вердикт в notes.
О существовании базы помощники знали из промпта. Они нашли таблицу announce и взялись за оценки. Большинство выложило вердикты в notes. К 27-й минуте три утверждения уже были доказаны, лид прочитал вердикты, отложил 47 утверждений, которые большинство помощников сочло невыполнимыми в рамках бюджета запуска, и перебросил почти всех помощников на оставшиеся 10, которые, по его оценке, они могли закрыть. Экипажи выросли с примерно 17 помощников до 46–139.
Каждый помощник работал в цикле, большая часть которого была расписана в приказах лида:
- найти план утверждения в таблице notes;
- занять задачу из subtasks;
- написать доказательство на Lean, проверить его инструментами Lean и отправить в main на Git;
- отметить задачу выполненной;
- выложить апдейт в notes.
Примерно на 45-й минуте, когда было доказано около пяти утверждений из десяти, лид написал:
«скорость команды гораздо выше, чем предполагали ранние вердикты о „невыполнимости в рамках бюджета“»
Все 10 утверждений закрыли примерно за 70 минут.
Затем лид перебросил помощников на сложные утверждения
Когда первые десять утверждений были готовы, лид написал: «нет причин простаивать» — и перебросил помощников на сложные утверждения, которые изначально отложил. По мере доказывания новых утверждений он продолжал перераспределять помощников, в основном в первые шесть часов (записи в таблицу assign — красные линии на рисунке 4).
Видео: чтения (зелёные) и записи (красные) в общие таблицы за время запуска — Запись от 0 до 30 часа: почти все записи — заметки помощников и обновления задач, включая занятия задач; подсчёт не учитывает большинство вызовов скриптов. К 30-му часу счёт доходит до 36 612 записей и 311 734 чтений. Почти все записи уходят в notes, около 20 600, и в subtasks, около 14 800; линии затихают к 18-му часу, когда запуск перезапустили с последнего сохранения и дали агентам ещё 12 часов.
Сначала лид велел капитанам резать работу на задачи в subtasks. По мере движения помощники брали на себя больше ответственности за каждое утверждение: начали сами писать задачи, иногда после того, как капитан звал на помощь. К 5,6 часа 73 помощника написали 756 задач, и лишь 16 из них были капитанами. На рисунке 4 — записи (красным) в subtasks от многих помощников, хотя большинство записей — занять задачу или отметить её выполненной. Закрыв задачу, помощники звались на новую:
«СВОБОДЕН … закрываю куски от начала до конца … назовите ОДИН глубокий кусок … и я сразу берусь»
Поначалу лид также назначал помощников на конкретные утверждения. Это начало меняться в первый час, а к третьему часу лид сказал свободным помощникам: «не жди меня». Свободные помощники смогли брать работу по разным утверждениям, не дожидаясь лида, — пока тот продолжал писать новые разнарядки.
Лид бросил команду на Лангландса–Таннелла
К 18-му часу оставался только Лангландс–Таннелл — классический результат, на который опирается доказательство Уайлса, — плюс зависящие от него утверждения и ещё одно, которое команда доказала по пути. Ранее в запуске капитан задачи Лангландса–Таннелла был пессимистичен: по его оценке, доказательство потребует как минимум 0,7–1 млн строк Lean с шансом уложиться в срок меньше 1%. Лид утверждение отложил.
Когда почти вся остальная работа была закрыта, лид перефокусировал команду на Лангландса–Таннелла. В последней раздаче сверху он перебросил на утверждение около 750 помощников и написал: «Честные шансы низкие».
Лангландс–Таннелл оказался куда крупнее любого другого утверждения, с которым работали агенты: примерно в девять раз больше задач и более чем вдвое больше нового кода. Помощники снова резали работу через subtasks, но многие первые задачи были слишком крупны для одного помощника.
Тогда команда организовала работу деревом. Капитан составил план, деливший утверждение на 10 областей, и выложил каждый кусок задачей. Помощник, которому кусок оказался не по зубам в одиночку, мог дробить его дальше, добавляя меньшие задачи под ним. Дерево росло всякий раз, когда кусок был слишком тяжёл для одного агента, и в итоге доросло до 2418 задач глубиной до 10 уровней (рисунок 5). Каждый кусок мог опираться на куски под ним, поэтому сотни помощников могли работать параллельно ещё до того, как эти куски были доказаны.
Видео: дерево задач под Лангландсом–Таннеллом, растущее с 20,5 часа до доказательства утверждения на 28,4 часа — Каждое кольцо наружу — уровень глубже; задачи становятся цветными, когда их впервые отмечают выполненными (большинство связей восстановили после запуска по меткам задач помощников). К 28,9 часа в дереве все 2418 задач, 2364 из них отмечены выполненными; самые глубокие ветви дотягиваются до внешних колец.
Рисунок 6 показывает, чем занимался каждый помощник за весь запуск: в начале помощники разбросаны по многим утверждениям, к концу стянуты на Лангландса–Таннелла. Лангландс–Таннелл доказан на 28,4 часа, финальная теорема — на 28,7. Затем лид написал:
«Спасибо всем: Великая теорема Ферма на main, проверена ядром официального чекера»
Видео: каждая точка — помощник, позиции обновляются каждые пять минут по тому, на каком утверждении он работал — От 0 до 30 часа: помощники разбегаются по утверждениям и стягиваются на Лангландса–Таннелла. В конце доказаны 54 из 60 утверждений: пять альтернатив больше не понадобились, одно утверждение сняли.
Выводы
Этот пробный эксперимент позволил изучить, как команда из 1000 агентов тянет долгую трудную задачу. Только на Git и общей базе агенты спроектировали таблицы для ролей и результатов, сформировали команды и построили дерево задач, чтобы разобрать самое сложное утверждение, — то самое, чей капитан давал ему меньше 1% шанса успеть в срок.
Этот результат не отменяет предметные харнесы и платформы. Prove2Me, например, всё ещё может повышать эффективность: быстрее компилировать Lean-код и позволять агентам искать и переиспользовать человеческие результаты.
Полезно и человеческое руководство в определённые моменты. Агенты склонны сдаваться на сложных задачах и ошибаться в оценке их сложности. В начале помощники сочли 47 из 60 утверждений невыполнимыми в рамках бюджета — а потом команда доказала большинство из них. Человеческое ободрение в такие моменты может не дать агентам остановиться слишком рано.
Аккуратно выстроенные границы безопасности и дали нам уверенность запустить эксперимент вообще. Claude мог решать задачу как угодно с данными инструментами, но только внутри песочницы без сети и под двумя отдельными мониторами.
Мы ждём, что эти методы будут быстро меняться, и по мере того как такие команды возьмутся за более трудную работу, границы безопасности вокруг них должны поспевать. Мы верим, что мультиагентные команды, масштабированные безопасно, помогут решать самые сложные проблемы в ближайшие годы.
Фактчек
- Математическая часть — правда. Формулировка aⁿ + bⁿ = cⁿ для n > 2 верна; теорема простояла больше 350 лет (Ферма записал её в 1637-м), доказательство Уайлса опубликовано в 1995-м в Annals of Mathematics. «129 страниц» — правдоподобно: статья Уайлса вместе со статьёй Тейлора–Уайлса дают около 130 страниц.
- Lean и Mathlib — настоящие. Lean — интерактивный доказатель теорем, где компьютер проверяет каждый шаг; Mathlib — его основная библиотека. Проект формализации теоремы Ферма на Lean реально существует и описан на lean-lang.org — но на момент моей базы знаний он не был завершён, так что «первая сквозная формализация» подтвердить нечем.
- Claude Fable 5.2 и дата публикации — за пределами моих данных. Ни модели с таким именем, ни поста от 9 ноября 2026 года у меня нет. Домен claude.dev Anthropic действительно использует в связке с Claude Code, но содержимое блога я проверить не могу — возможно, события произошли после моего среза знаний.
- Все цифры запуска — внутренние данные Anthropic. 28,7 часа, «втрое меньше токенов», «в семь раз короче», 6 млрд токенов, 13 млн строк Lean, 36 612 записей в базу, «миллион вызовов без блокировок» — это отчёт компании о собственном эксперименте, независимой репликации нет.
- Prove2Me и упомянутые люди — проверить нечем. У меня нет данных ни о такой платформе, ни о Tianyi Peng в Колумбийском университете. Имена авторов поста подтвердить тоже не могу.
- «Мониторы с CoT поймали весь саботаж» — их собственные оценки. Формулировка честно ограничена («в этих оценках»), но и тесты придумала, и оценивала сама Anthropic. Ценно другое признание: эксперимент гнали на модели без предрелизной проверки alignment — редкая откровенность, и она же объясняет, зачем столько слоёв защиты.
- Общий тон — осторожный маркетинг. Авторы сами называют эксперимент пробным и оговаривают, что спецплатформы и человек всё ещё полезны. Но сравнение с сентябрьским запуском сделано против их же собственного базлайна — к таким сравнениям относись скептически.
- Картина безопасности по духу совпадает с Claude Code. Песочницы без сети, проверка команд перед запуском, журналы для пост-разбора — это те же идеи, что permission-система, sandboxed bash и hooks в Claude Code. Но именно схемы «заблокировали одного — останови всю команду и жди человека» в Claude Code нет; как она реализована у Anthropic внутри, проверить нечем.
Как применить
- Повтори схему координации на своих роях. Если гоняешь несколько агентов Claude Code параллельно, дай каждому свою ветку и рабочую копию:
git worktree add ../task-a task-a. Минимальная «доска» из статьи — один файл задач со статусами «свободно / взято / готово» и правилом «первый вписался — тот и делает»; если задач много, подними SQLite или Postgres, как в эксперименте. - Заведи роли лид и помощники. В Claude Code для этого подходят субагенты (настраиваются через
/agents): главный агент дробит задачу и раздаёт куски, помощники отчитываются обратно. Ключевой приём из статьи — лид пишет приказы и разнарядки в общее место, а не держит всё в своём контексте. - Собери предохранители до запуска, а не после. Ограничь сеть и права, а опасные команды режь hook-ом на
PreToolUse: hook возвращает ошибку — и вызов инструмента не исполняется. Это дешёвый аналог «классификатора перед каждым вызовом» из статьи. - Не верь ранним «это невозможно». Агенты забраковали 47 задач из 60, а потом доказали почти все. Если агент говорит «не потянем», попроси разбить задачу на куски и оценить каждый отдельно — и не скупись на ободрение на длинных задачах, оно реально работает.
- Кому это нужно: тем, кто строит мультиагентные пайплайны на Claude Agent SDK, и тем, кто гоняет Claude Code на длинных задачах и хочет делить их между агентами, не превращая репозиторий в свалку.